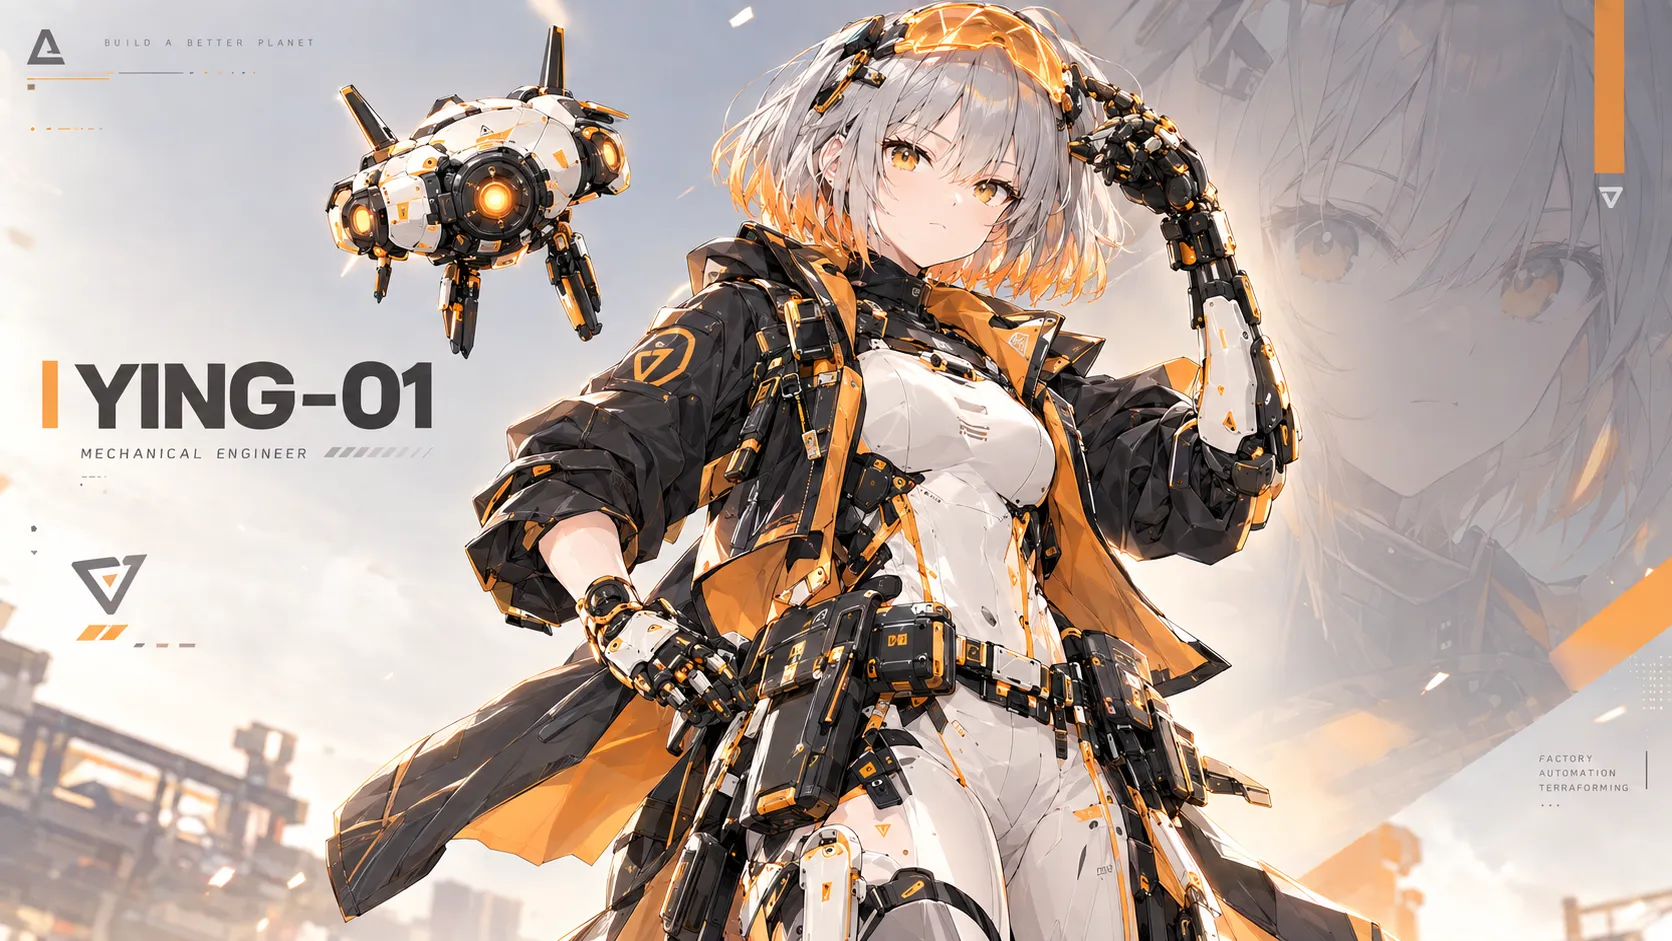
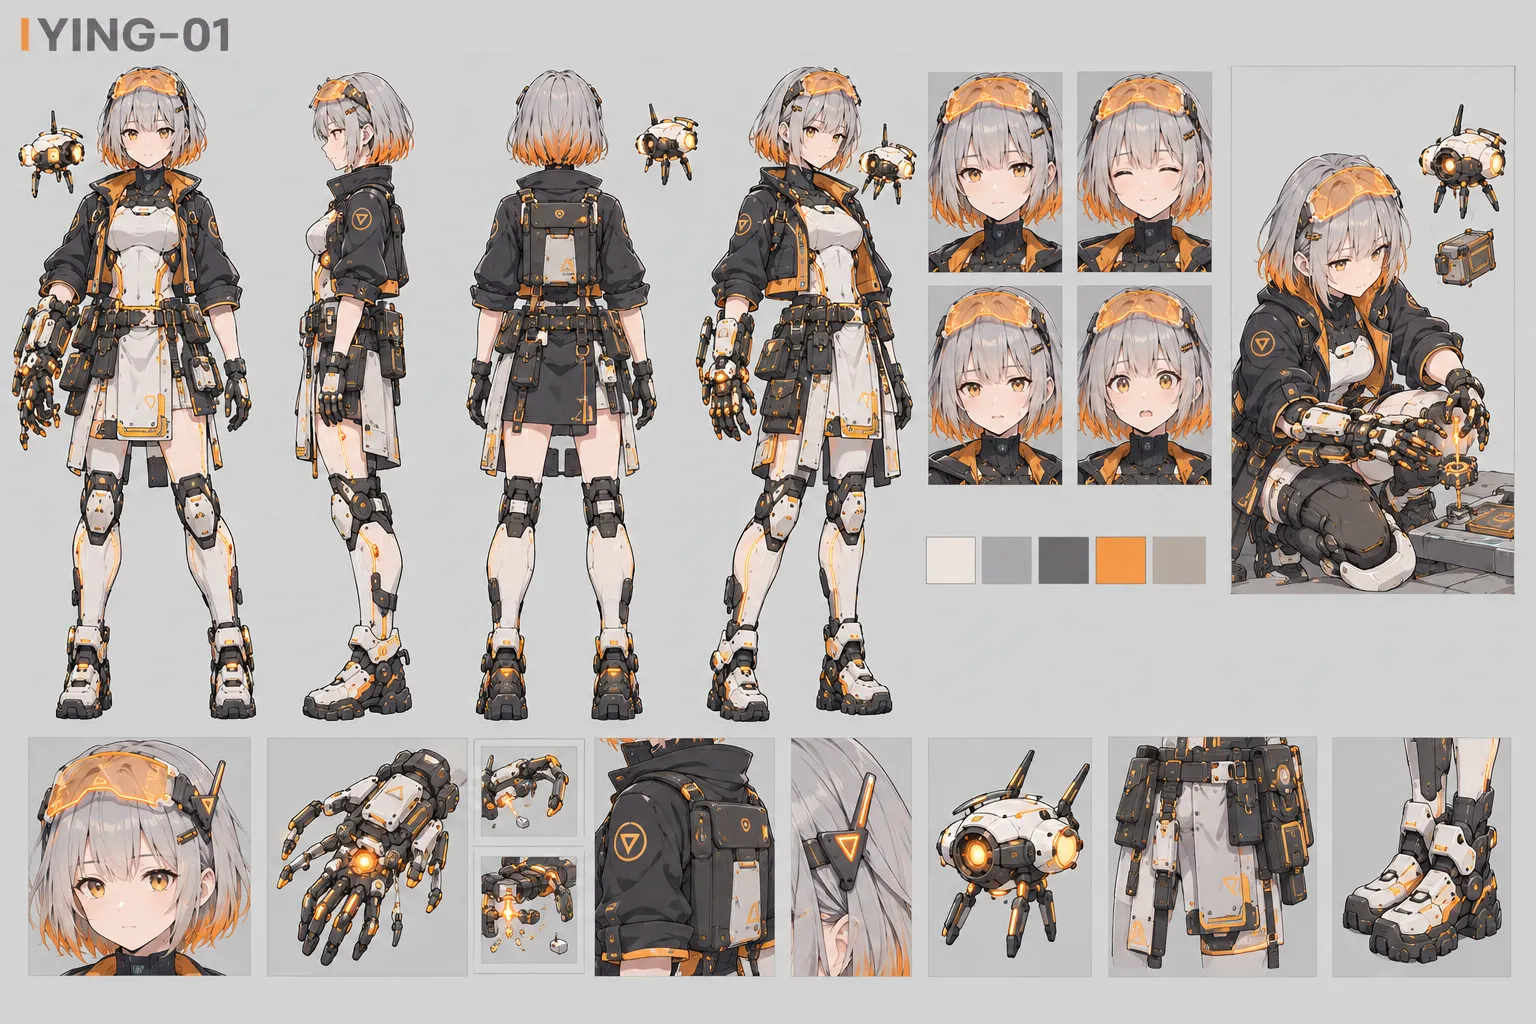
以前の3キャラクターのデザインで、萤のキャラクターシートをすでに生成していました:
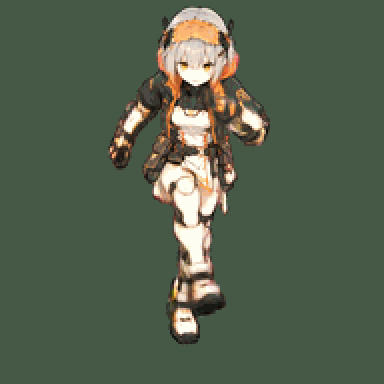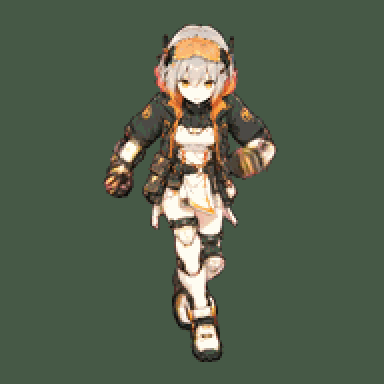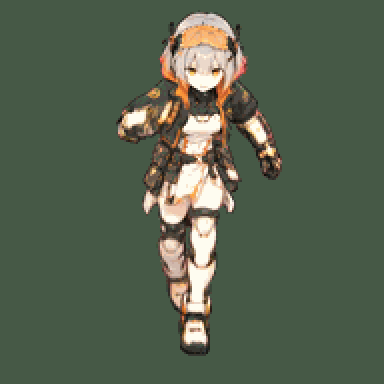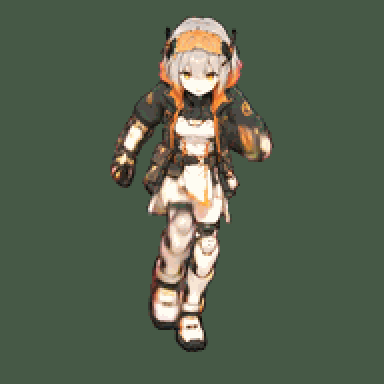
このポストは、ゲームマップ上の俯視スプライトアセットについて記録しています。最終結果は以下の通りです(左から右:南、東、北、西;歩く → 停止 → 待機):
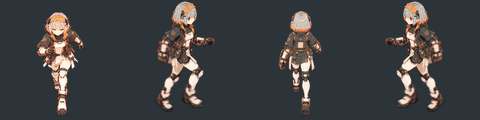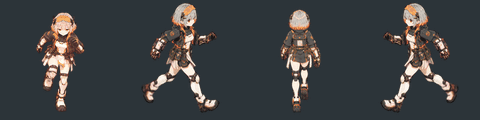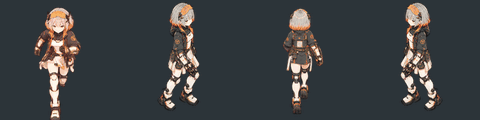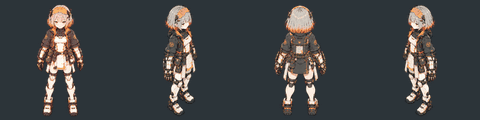
完全には満足していません (´;ω;`)が、ゲーム内でほんの百ピクセル程度の高さのアセットにとしては、今のところは十分です—何にせよ、途中で得たものより遥かに良いです。
以下は失敗作のコレクションです ( ´•︿•̥ )
失敗作
1. フラットなアングルのアンカーポイント
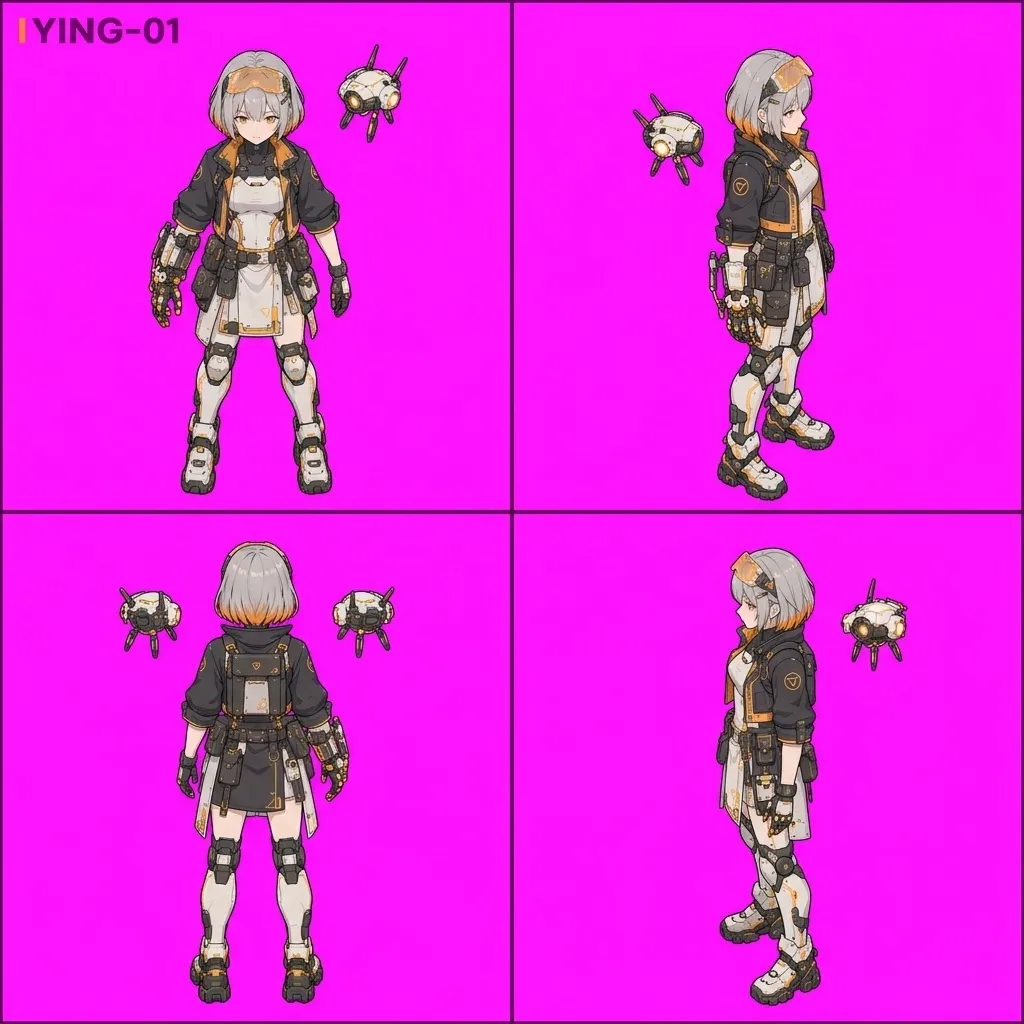
最初のステップは、後続の全フレームが従う4方向の「アンカー」シートを作成することでした。最初に得たものはアイレベルで描かれていました。それ自体は良く見えましたが、ゲーム内のすべての建築物は約35°の俯視角から描かれているため、キャラクターはシーンに貼り付けられたステッカーのように見えました。
2. Gemini Flash:1つの長いストリップ全体で歩行
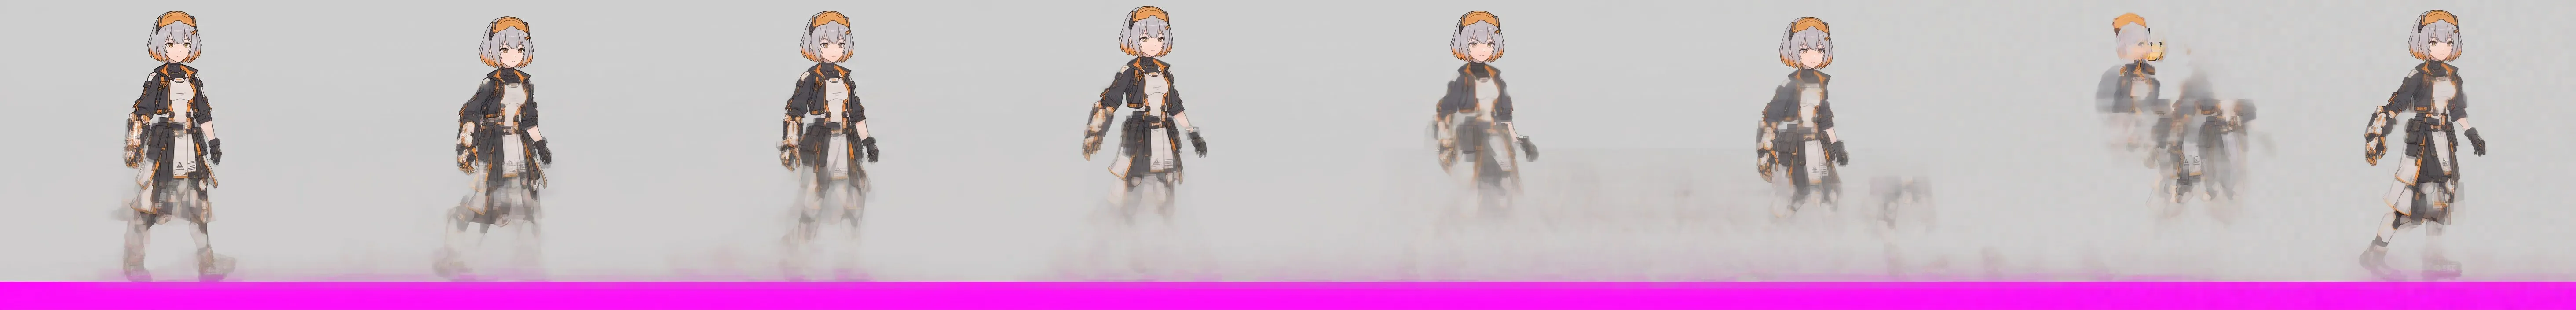
シンプルなアイデア:モデルに8:1のストリップを描かせる、8セル、8フレーム。下に行くほど身体がぼやけていき—脚が基本的に消えて—各セルが異なる背景色を持っていたため、キーイングは不可能でした。
3. Gemini Pro:グリッド
次に、より強力なProモデルに2×4グリッドを描かせました。正直に言うと良く見えました—しかし正面図を要求したのに側面図を得て、セル間でステップが流れず、キーイングできるきれいな背景色ではありませんでした。
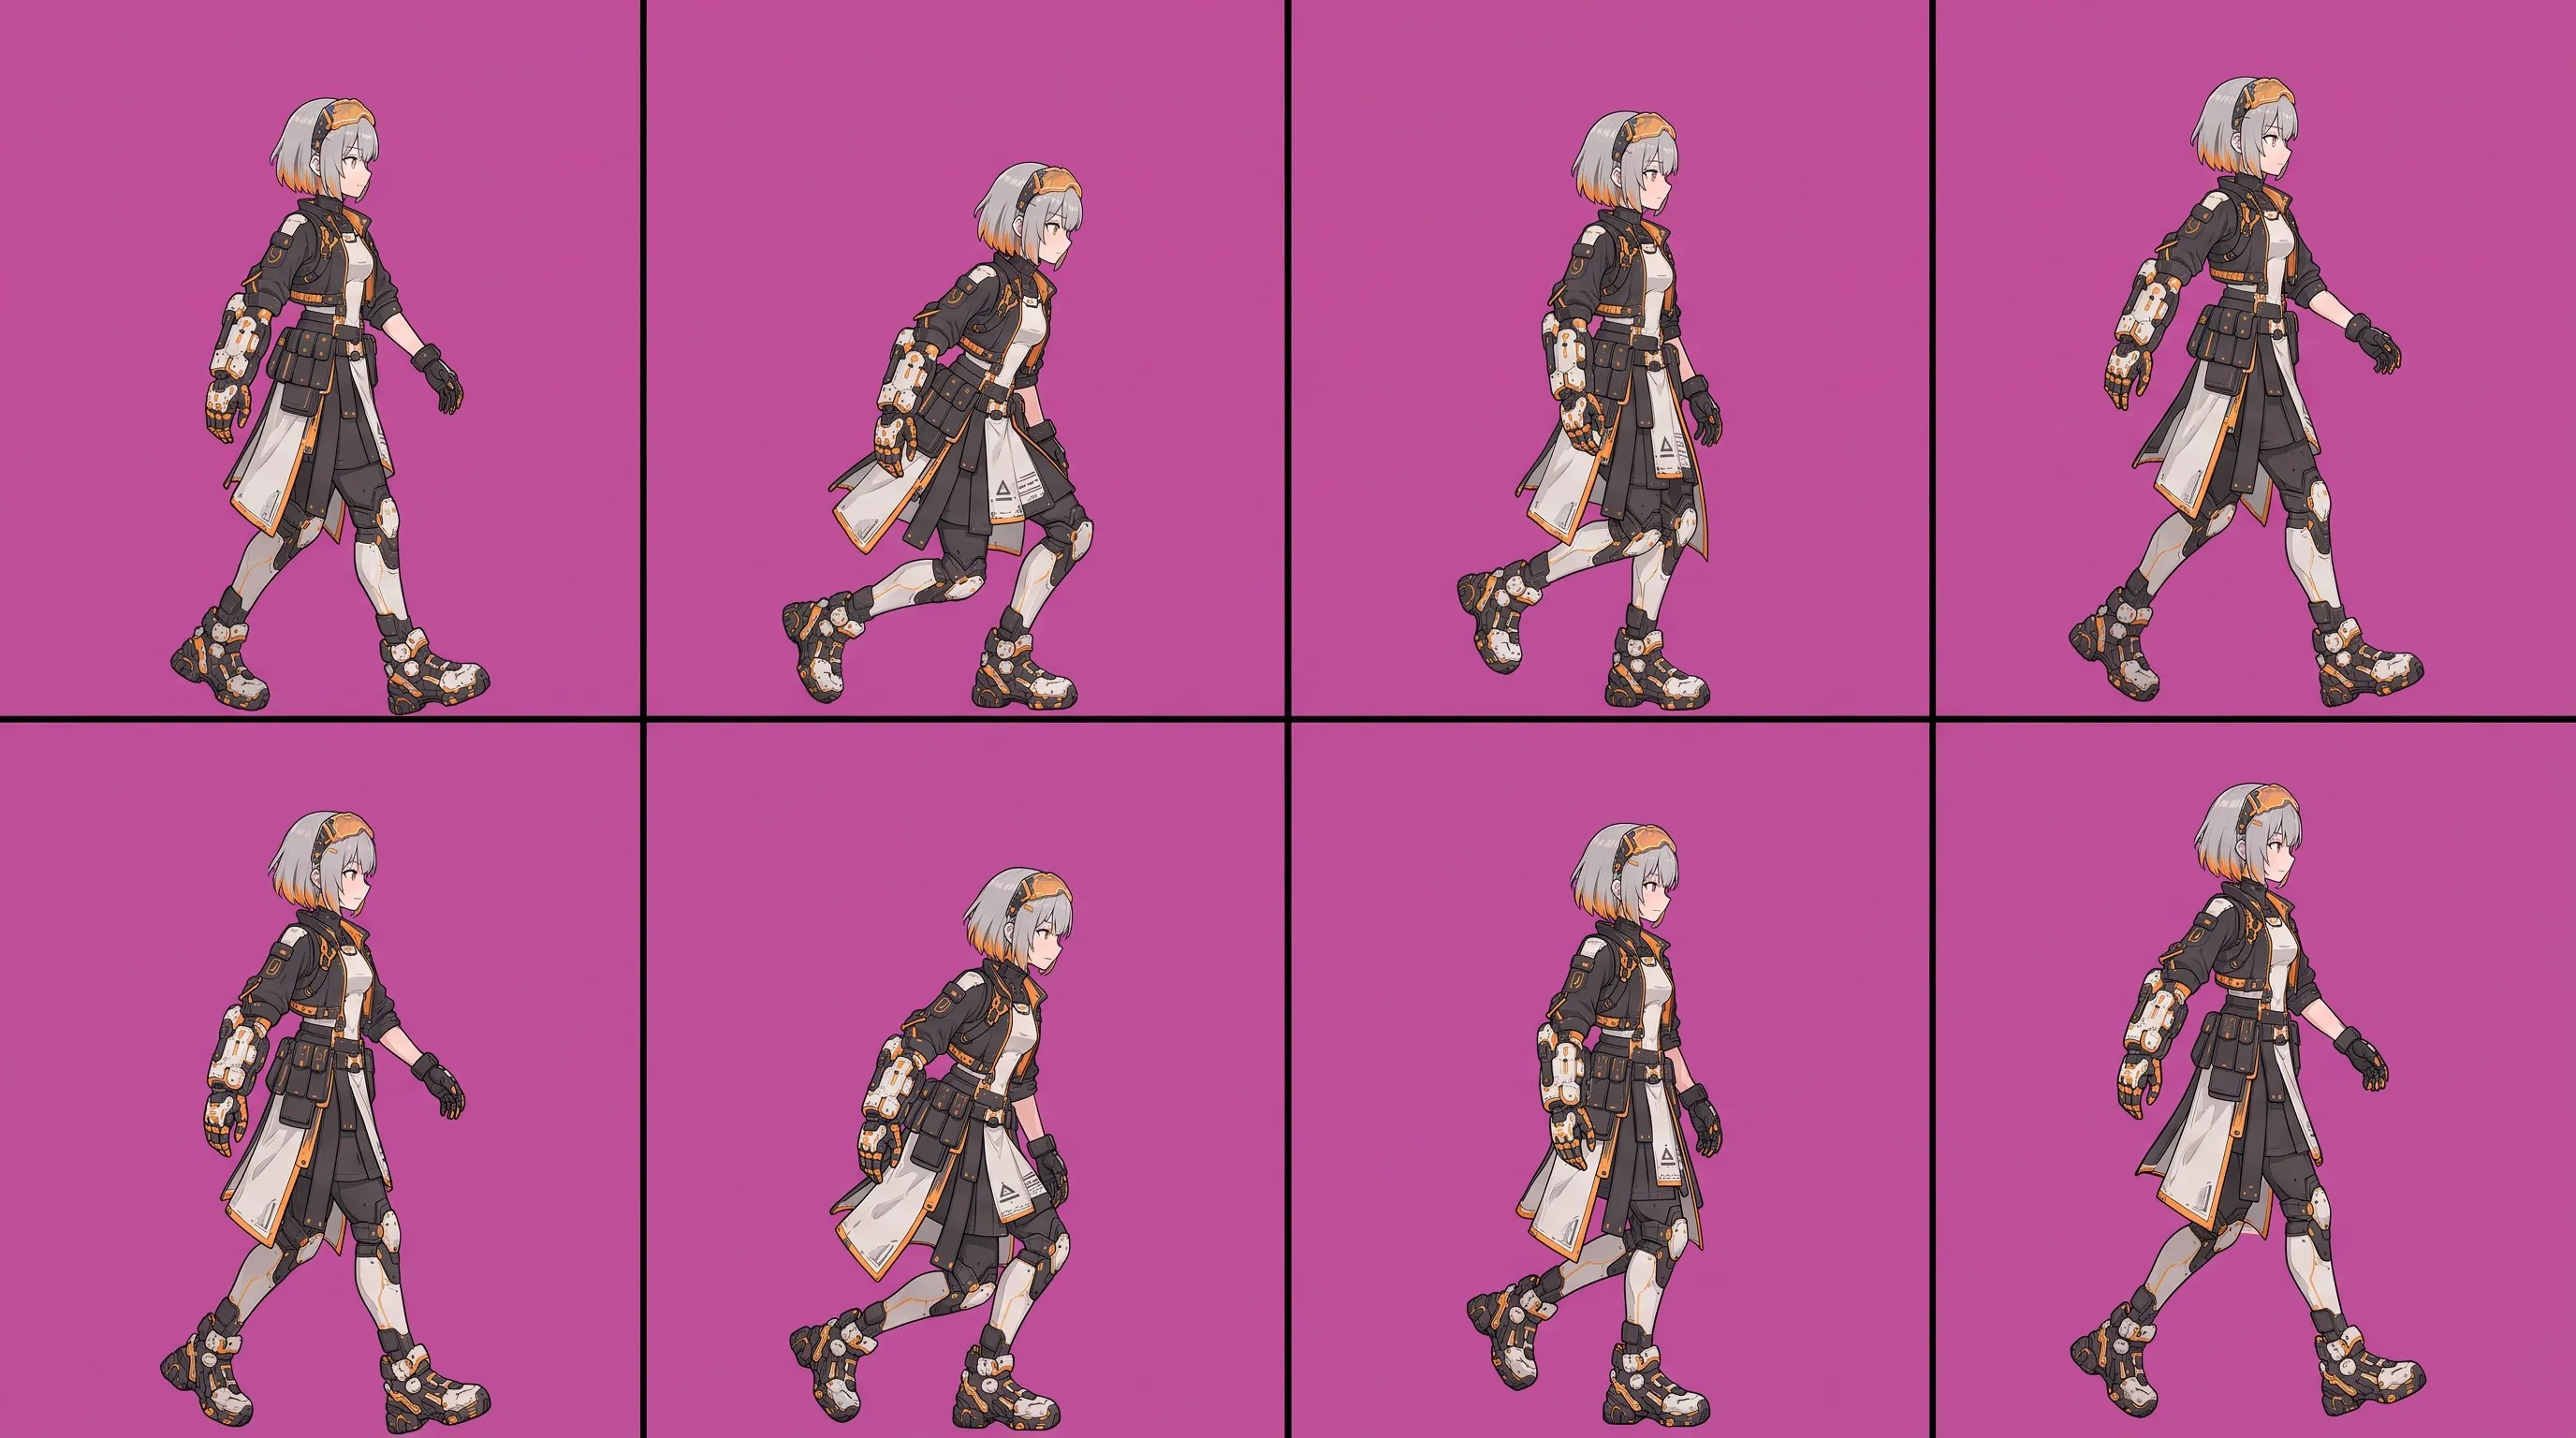
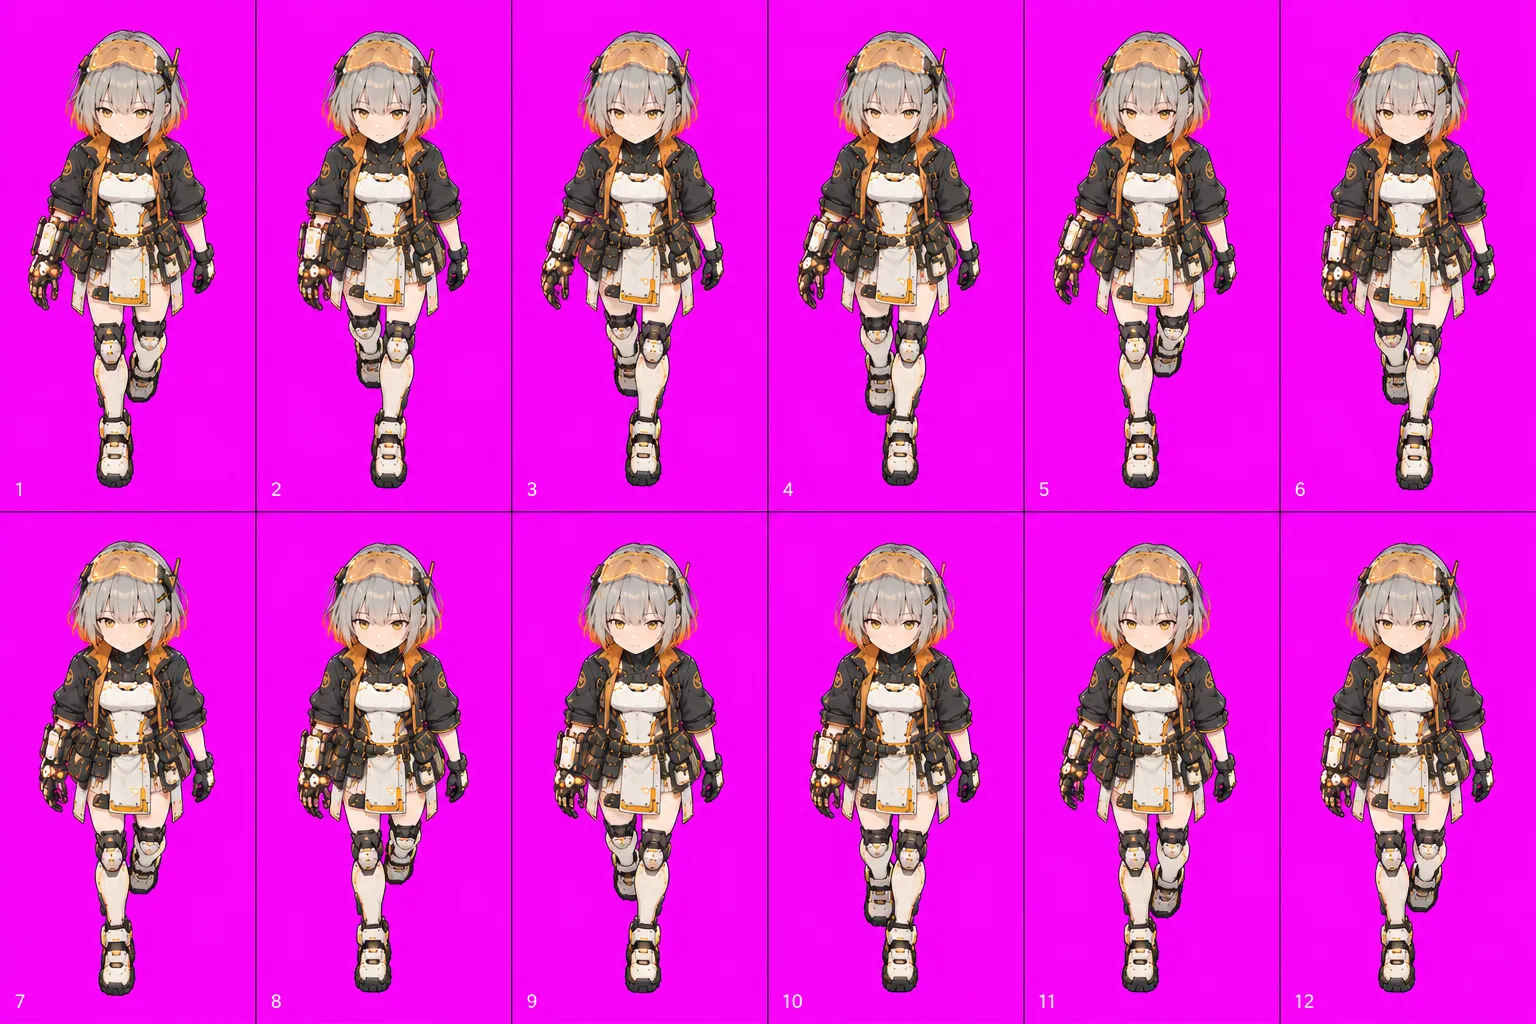
4. ChatGPT:1つの画像内のすべてのフレーム
ChatGPTは単一のポーズに非常に信頼できるため、1つの画像内で12セルの正面歩行を要求しました。問題は連続性の感覚がないこと:隣接するセルはしばしば前にある足を切り替え、脚が交差する中間のポーズがありません。再生すると、彼女はその場でけいれんするだけです。
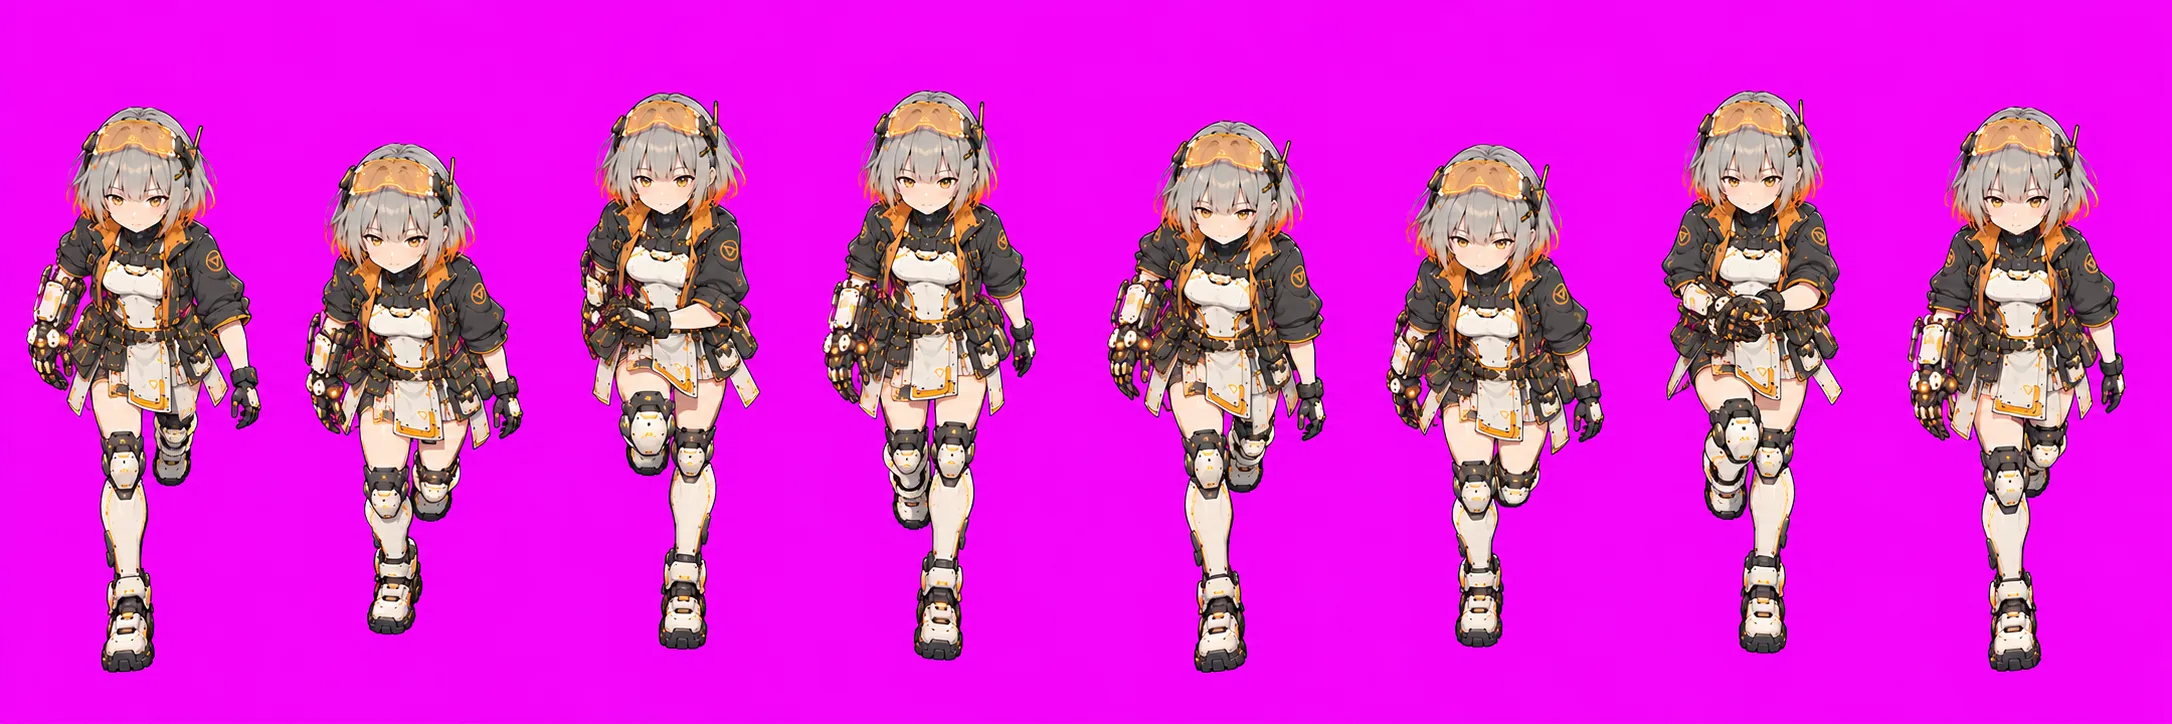
5. Veo:言葉でのみ動きを説明する
イメージモデルが連続性を理解しない場合、Veoで歩行ビデオを生成し、そこからフレームを抽出してみませんか?動きは連続でした—しかし、アンカー画像と短いテキスト説明だけでは、非常に「上品」に歩き、エネルギーがありませんでした。プロンプトが長いほど、Veoは単一の単語にしがみつき、それを誇張しました。
最後にうまくいったこと
この時点で教訓は明確でした:各モデルが得意なことだけをやらせる。
- ChatGPT(web)は静止ポーズのみを描く:立つアンカー、大きな歩幅の瞬間のキーフレーム。
- Veoは2つのポーズ間の動きだけを処理する:最初/最後フレームモードで、最初と最後のフレームを与えると、その間の4秒を埋めます。
- スクリプトが残りを処理する:キーイング、サイズ正規化、フレーム選択、スプライトシートのパッキング。
最初に動きを分解する
何を生成する前に、ゲームが正確にどのような動きが必要で、どのように接続されているかを確認しました。マップ上の萤の動きは3つの部分に分かれています:
| 動き | 再生 | 生成元 |
|---|---|---|
| 歩く | ループ | キーフレーム A → B → A |
| 停止 | 1回 | キーフレーム → 立つ |
| 待機 | ループ | 立つ → 立つ(呼吸) |
スイッチングルールはシンプルです:
方向キーを押す → すぐに歩き始める(スタートアップ遷移なし;フィール優先)キーを放す → 「停止」を1回再生、その後待機へ停止中に再度押す → 中断、歩行に戻るスタートアップ遷移を省略するのは意図的です:プレイヤーがキーを押した瞬間、キャラクターは動く必要があります—わずか数フレームの遅延でも「粘着性」を感じさせます。停止は逆です:数フレームの落ち着きは自然に見えます。
別のコツ:歩行途中で放すと、半分の確率で反対の足が前にあります。正面図と背面図は左右対称なので、その場合、停止アニメーションをミラーリングして再生すれば、うまく接続できます—追加のビデオは不要です。側面図はこれを取得しません。ミラーリングすると向く方向も反転してしまうためです。
このように分解すると、各方向は2〜4本の短いビデオだけが必要で、すべてはキーフレームと立つポーズの2つの画像を中心に回転します。
1. アンカーとキーフレーム
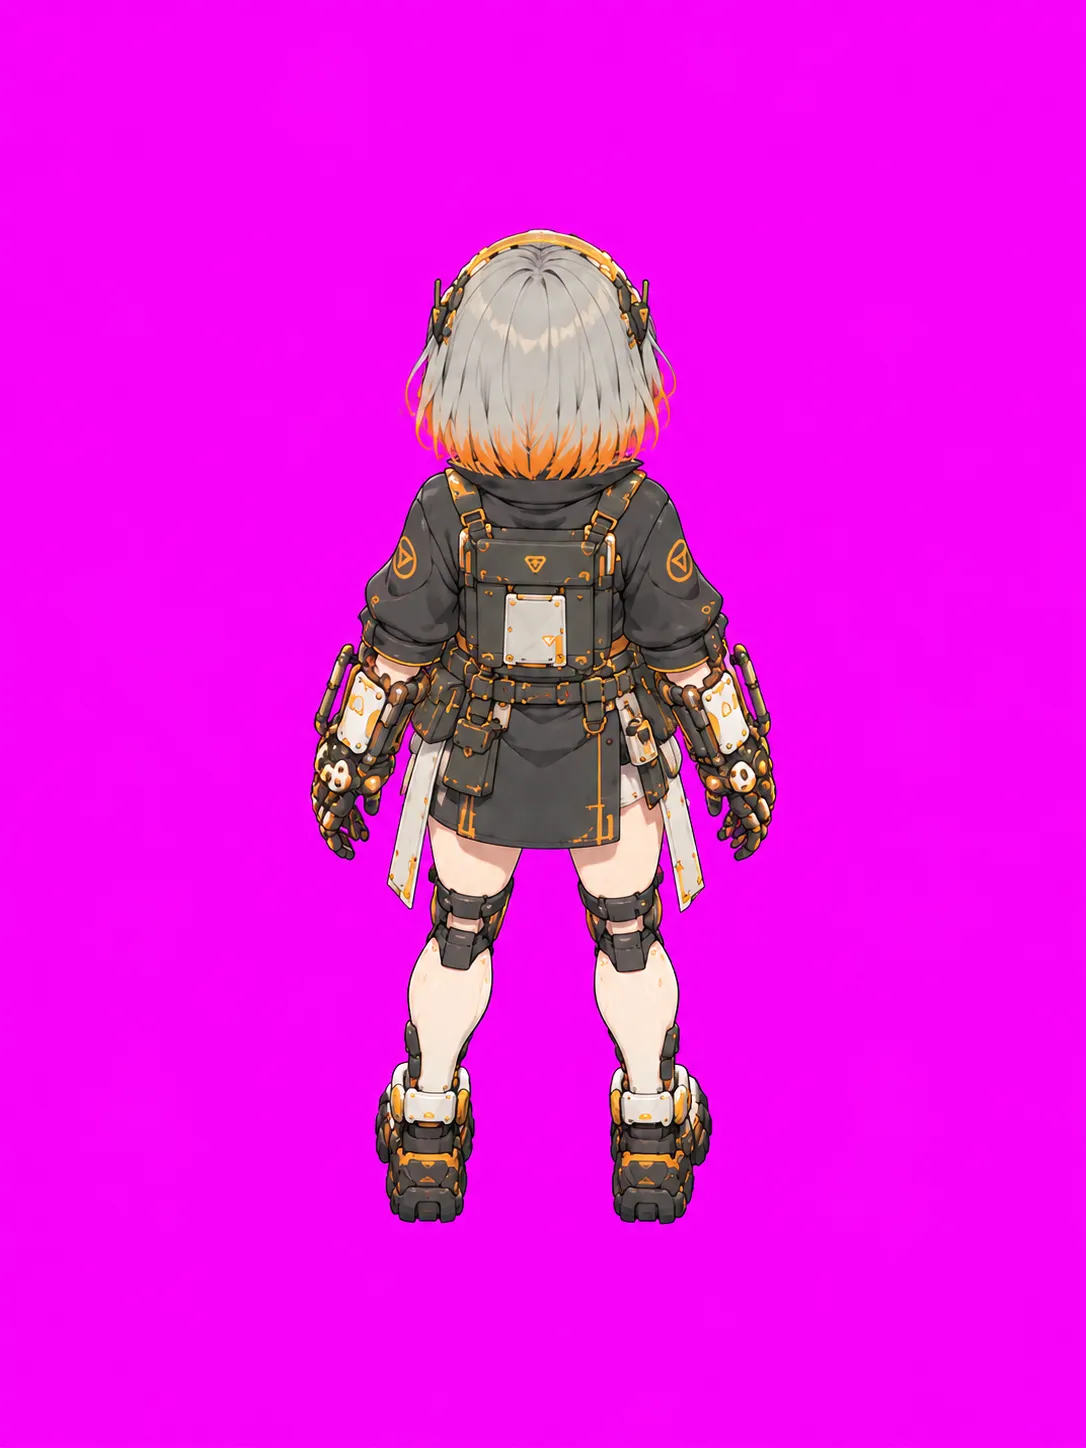
まず、ChatGPTは35°の俯視角の4方向立ちアンカーを描きます。これでカメラ角度が決まります:
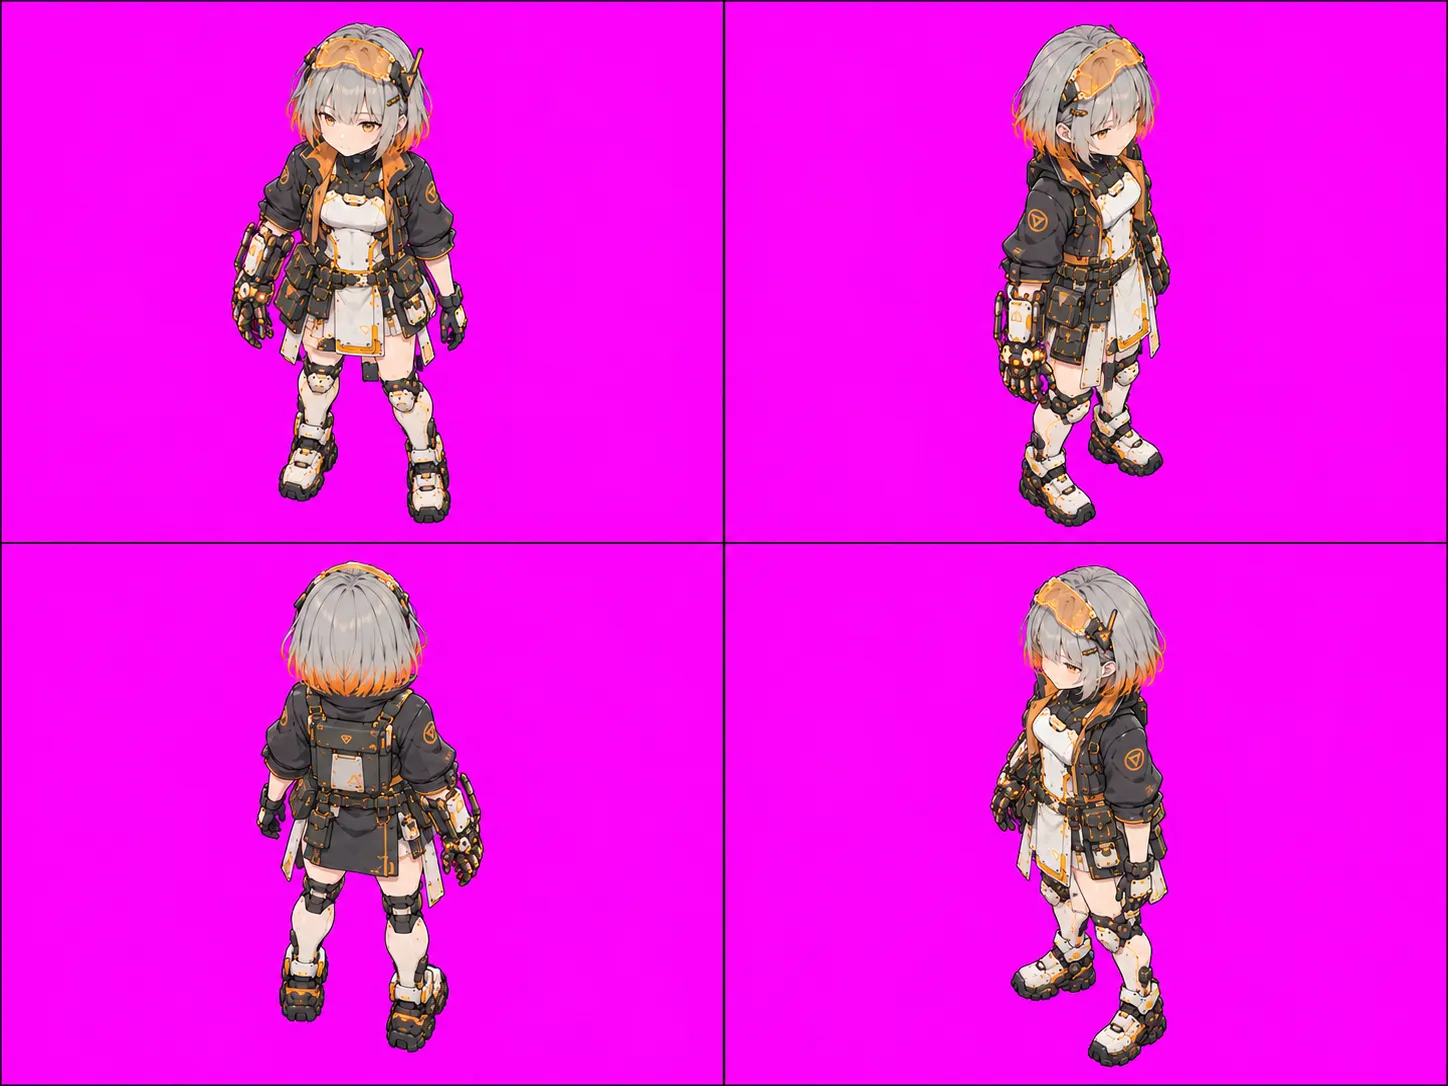
次に、各方向のキーフレーム:大きな歩幅の瞬間、一本の足が前に。正面と背面は対称なので、「反対足が前」フレームは単なる水平ミラー—再度描く必要はありません。
2. Veoが動きを埋める
各方向が数本の4秒ビデオを取得します:
- 歩く:キーフレーム A → ミラーB、B → A;2つを結合すると完全な歩行サイクルが得られます
- 停止:キーフレーム → 立つ
- 待機:立つ → 立つ、優しい呼吸だけ
プロンプトは可能な限り短く、動きだけを説明します。例えば「活発な長い歩幅、カメラに向かう、カメラは静止」。教訓:説明が長いほど、ドリフトします。
3. 側面図:最初と最後のフレームに同じ画像を使う
側面図が最も難しかったです。「反対足が前」の側面ポーズをChatGPTに描かせると、プロンプトをどう書き換えても、2つの画像がほぼ同じになりました。
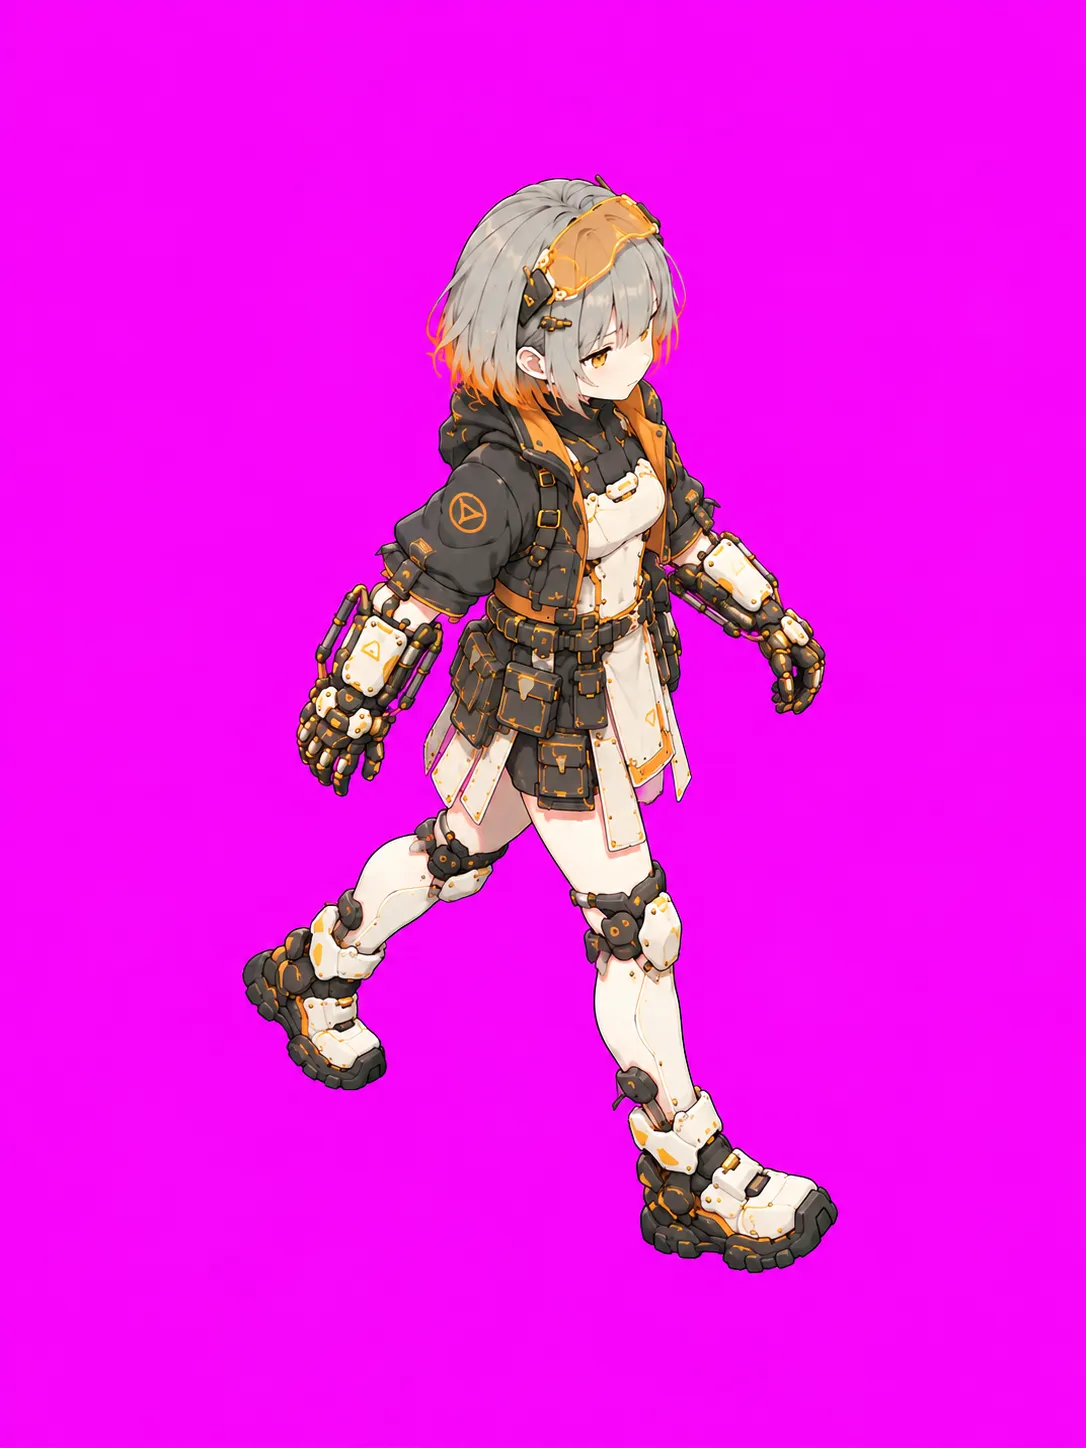
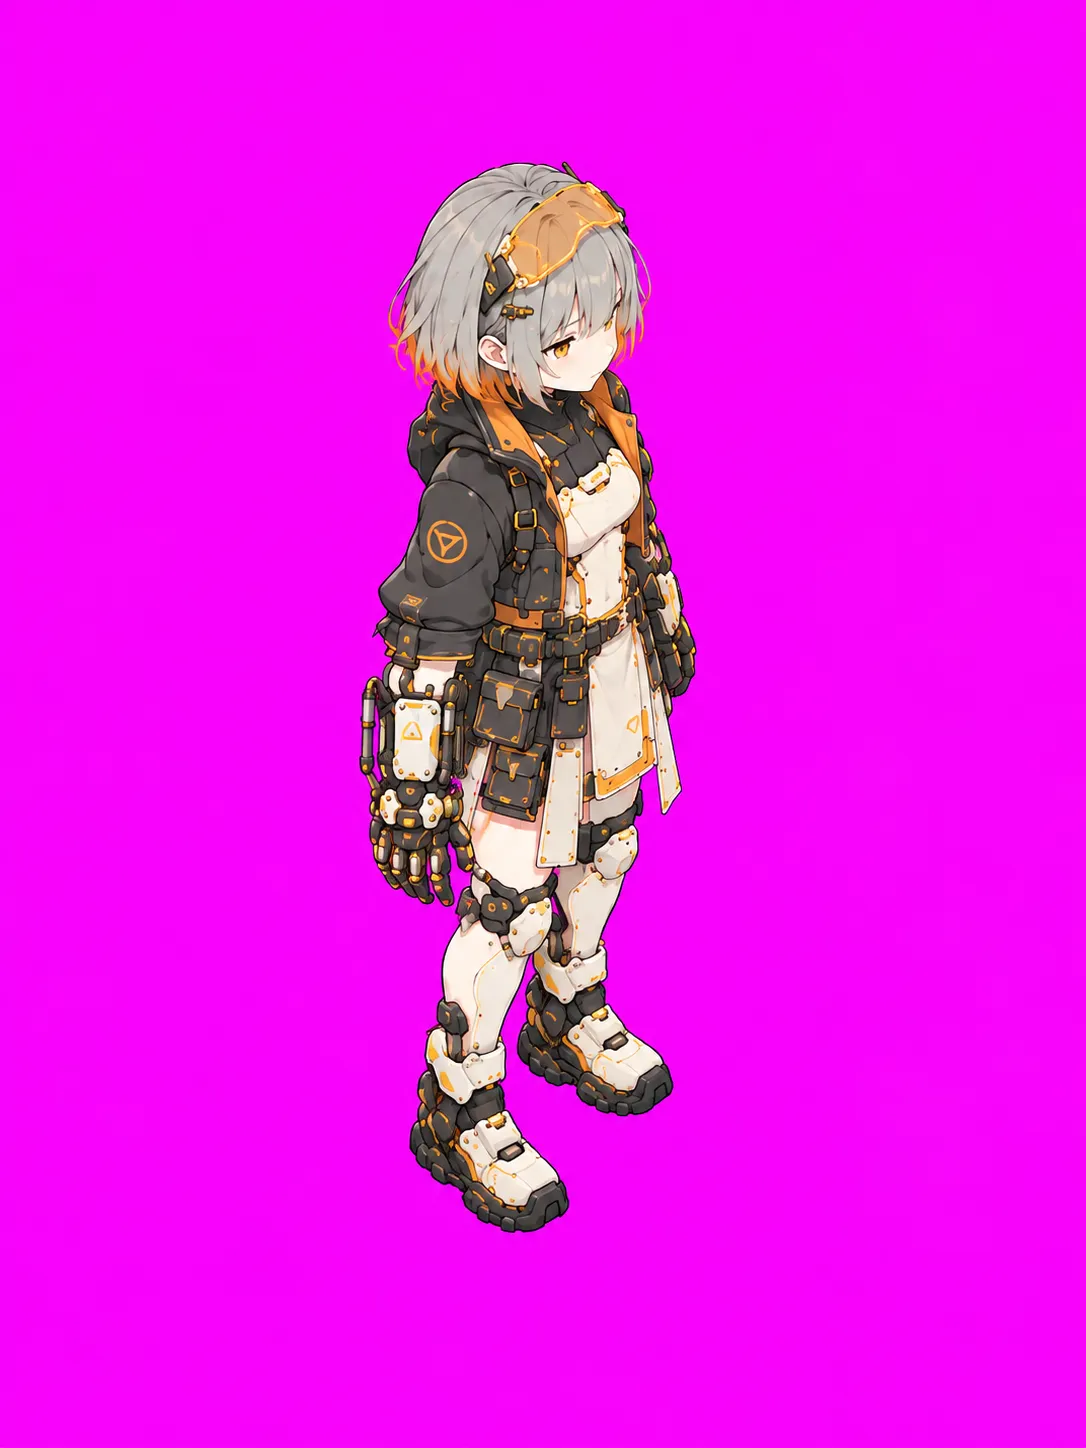
そこで2番目の画像を完全に削除しました:同じキーフレームが最初と最後の両方のフレーム、Veoは彼女を完全なサイクルで歩ませて開始ポーズに戻し、ビデオの中間から1つの完全な歩行周期を切り出しました。実は上手くいきました。西は単に東のミラーです。
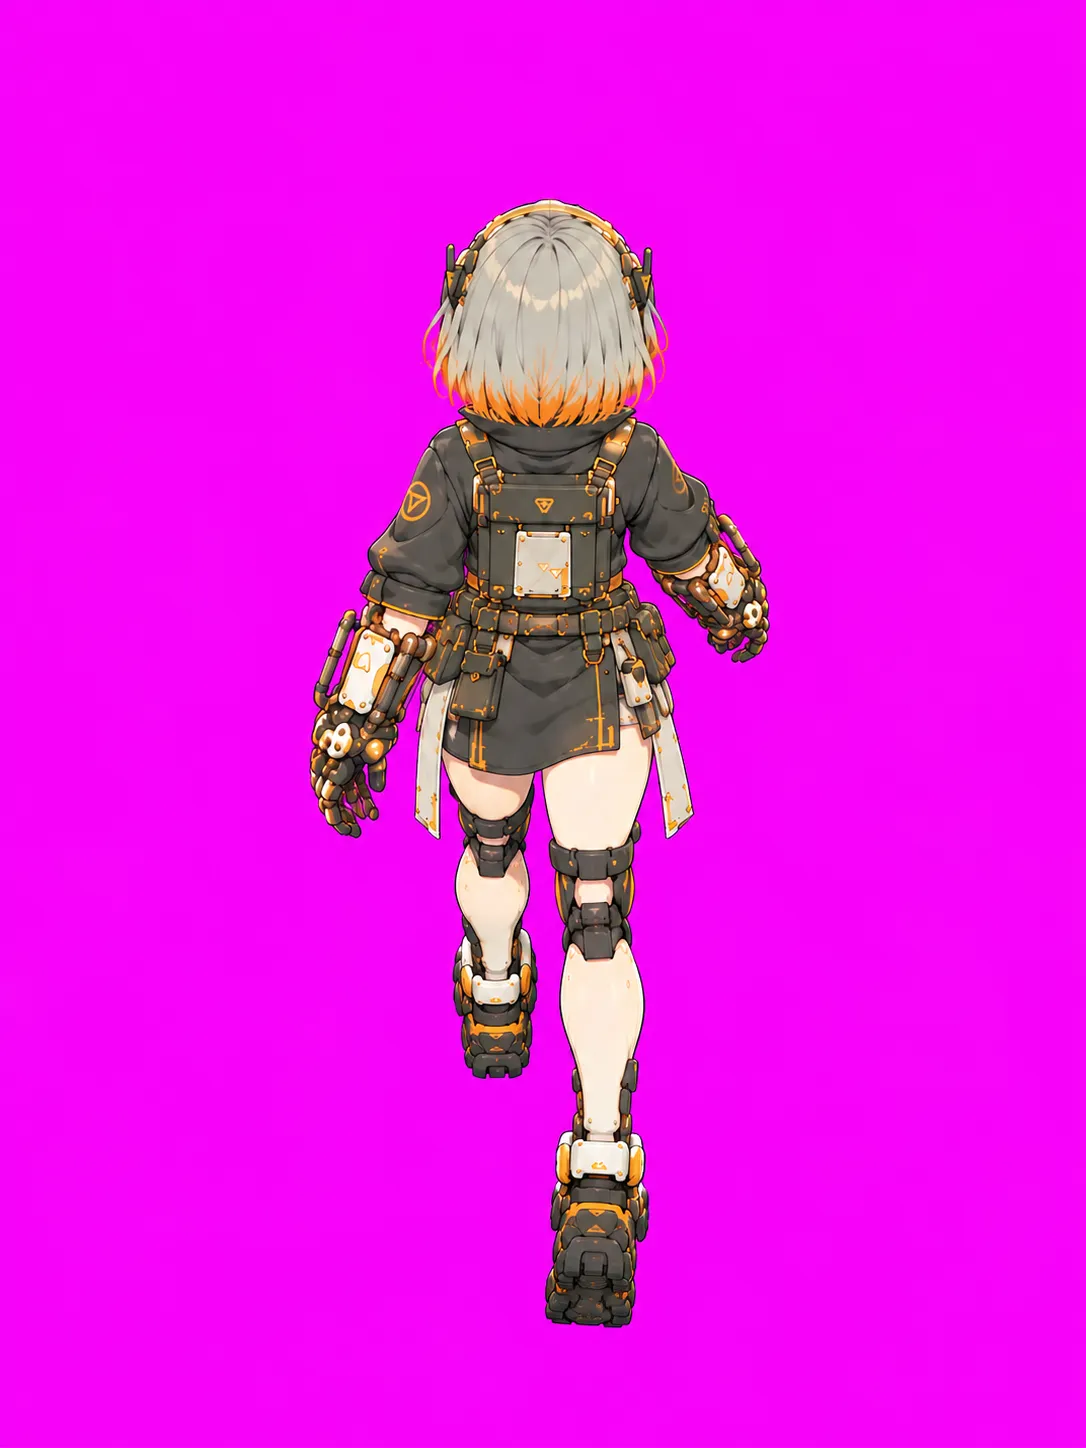
4. 背面図:悪い部分をカットする
背面図は正面図のレシピに従いましたが、1つのビデオで彼女の脚が突然左に蹴り出されました。再生成すると半分は修正されました;残りはエディットで修正しました—悪い部分の両側で最も似たフレームを見つけて直接結合します。継ぎ目はほぼ見えません。
5. フレーム選択とサイズ補正
ビデオ内の速度は均一ではありません—一部は速く、一部は遅い。固定時間間隔でサンプリングするとゲーム内アニメーションがカクカクします。代わりに動きの量でサンプリングします:
各フレームペア間の変化 → 「動きの進行」曲線に累積その曲線に沿って均等に12点を取得 → それが12フレーム別の落とし穴:ChatGPTのキーフレームは一貫して立つポーズより少し大きく描かれているため、歩くときに成長と縮小します。修正は頭の幅から比率を計算し、歩行フレームを立つサイズに戻すこと;停止アニメーションは歩行サイズから立つサイズへ段階的に変化するため、停止した瞬間にポップはありません。
最後に、4方向すべての歩く、停止、待機が1つのスプライトシートにパックされ、ゲームが行ごとに読み取ります。ここでは、元のVeoビデオから直接切り出されたすべての動き—ダウンスケールなし、カラー補正なし—詳細が見えるように:
コスト
萤の全試行錯誤プロセス、上記のすべての失敗した試みを含め、API使用で**$6.91**の費用がかかりました(ChatGPT webはサブスクリプションであり、カウントされません)。
要点
- イメージモデルは単一ポーズに優れ、連続フレームに劣ります;ビデオモデルはその逆です。各々でその半分を使いましょう。
- プロンプトを短く保ち、参照画像に語らせます。
- 側面図は2つのキーフレームを必要としません—最初と最後のフレームとして同じものを使用してください。
- 時間ではなく、動きでフレームをサンプリングします。
このパイプラインは序と遥に再利用され、仕事などの新しいアクションに使用されます。次回はより少ない落とし穴で (๑•̀ㅂ•́)و✧