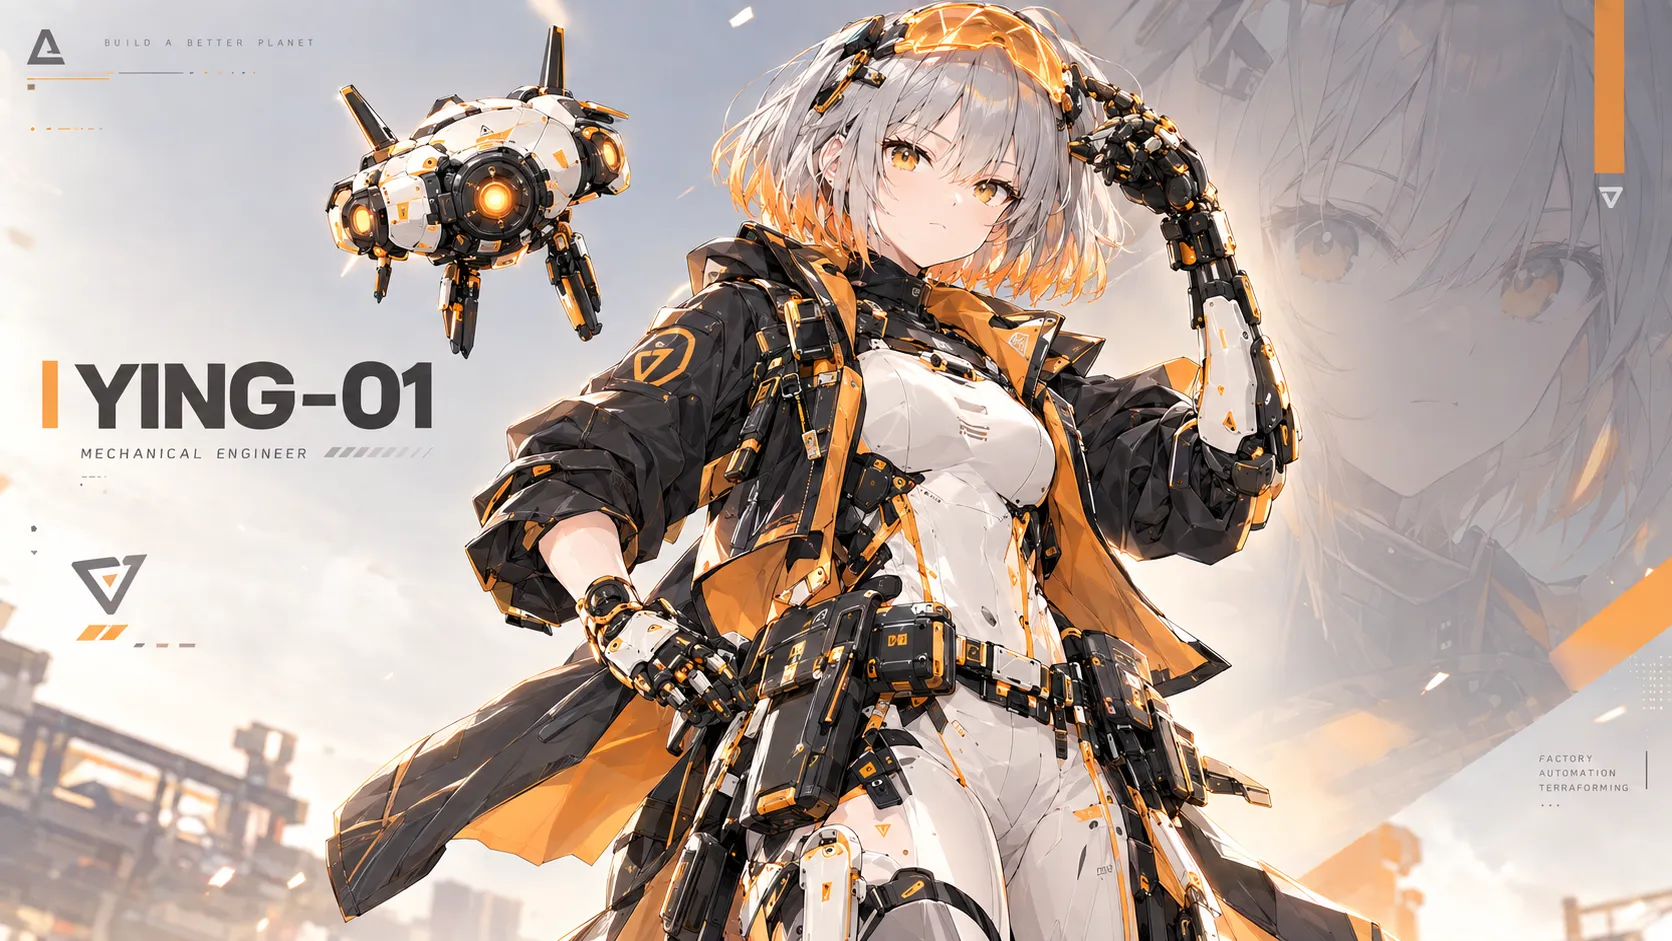
En el post sobre nuestros tres personajes, ya habíamos generado la hoja de personaje de Ying:
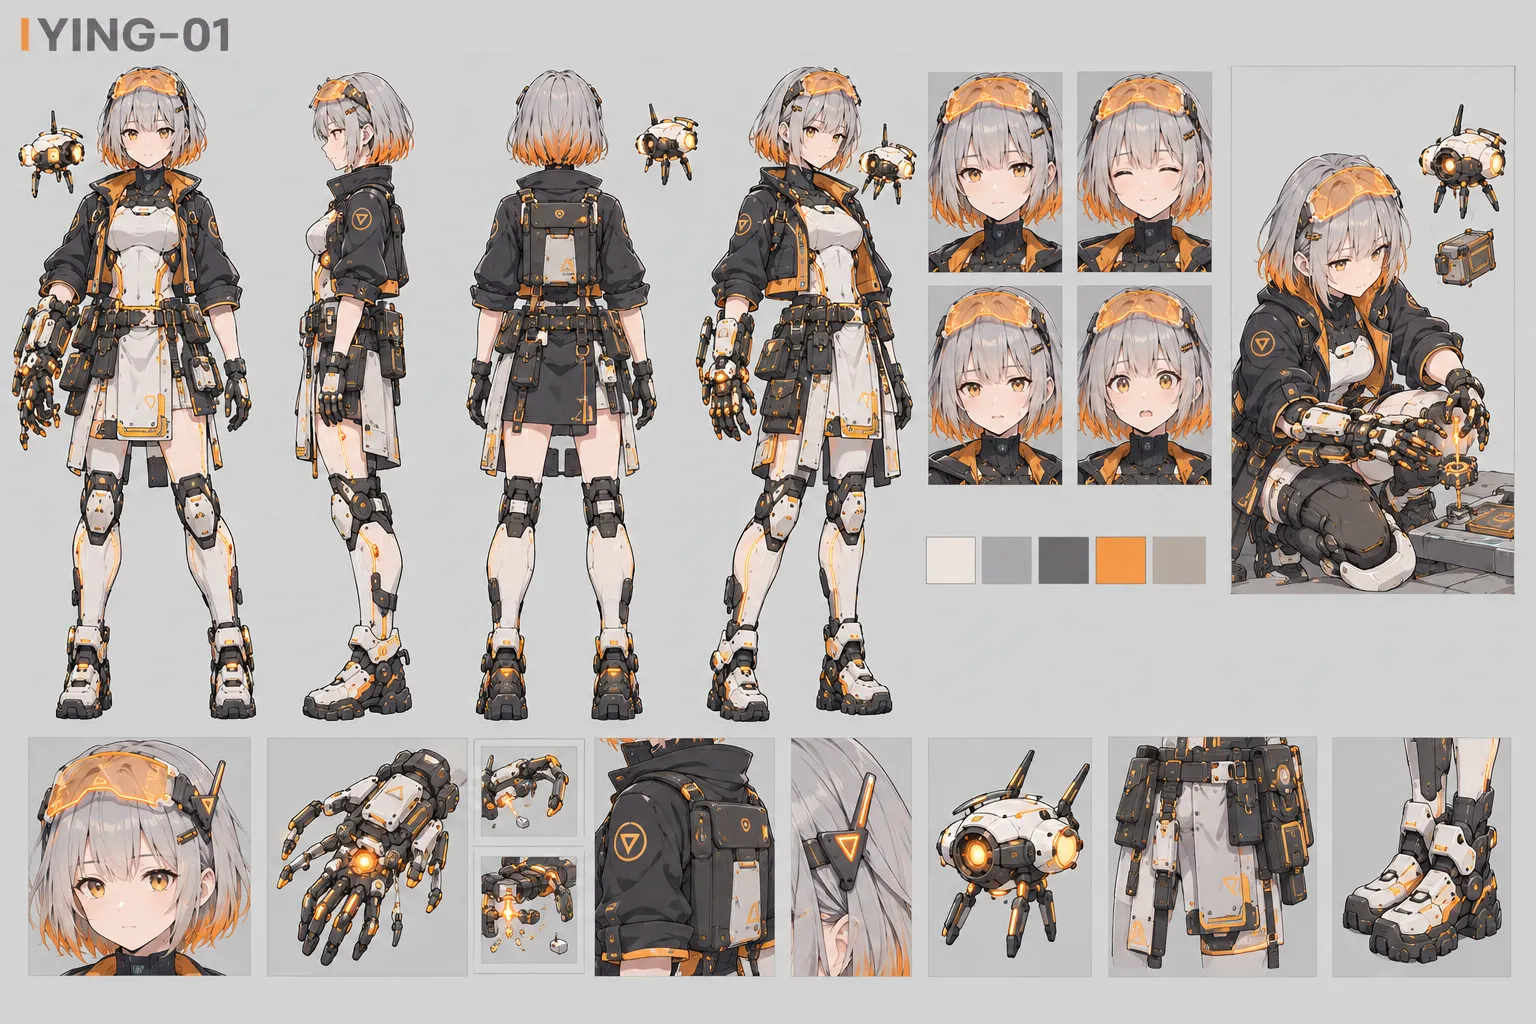
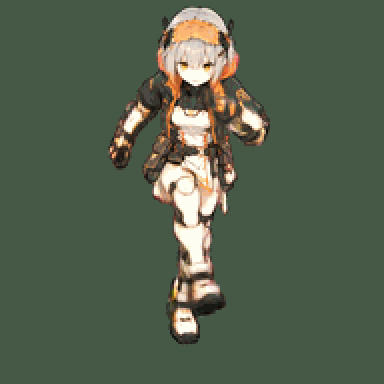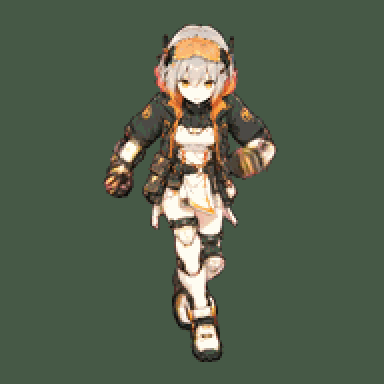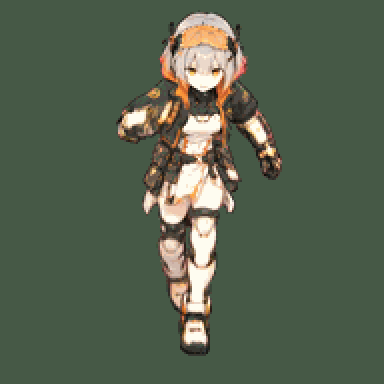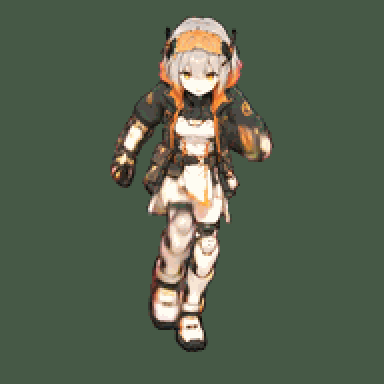
Este post documenta su sprite en vista superior en el mapa del juego. Aquí está el resultado final (de izquierda a derecha: sur, este, norte, oeste; caminar → detenerse → esperar):
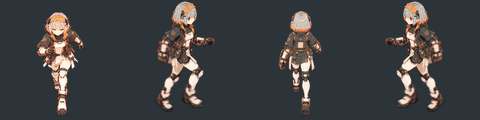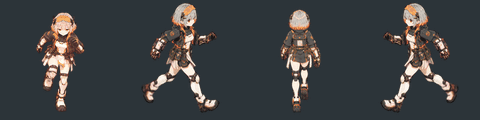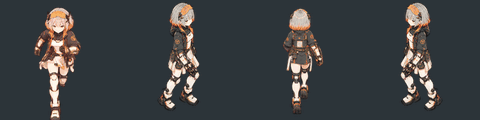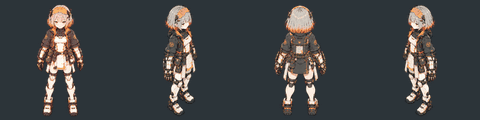
No estoy completamente satisfecho (´;ω;`), pero para un recurso que apenas mide cien píxeles de altura en el juego, es lo suficientemente bueno por ahora — y es mucho mejor que cualquier cosa que obtuve en el camino.
Aquí está mi colección de errores ( ´•︿•̥ )
Errores
1. Anclaje de vista plana
El primer paso fue crear una hoja “anclaje” de cuatro direcciones que siguiera cada fotograma posterior. El primero que obtuve fue dibujado a nivel de los ojos. Por sí solo se veía bien, pero cada edificio en el juego se dibuja desde aproximadamente un ángulo superior de 35°, así que el personaje se veía como una pegatina pegada a la escena.
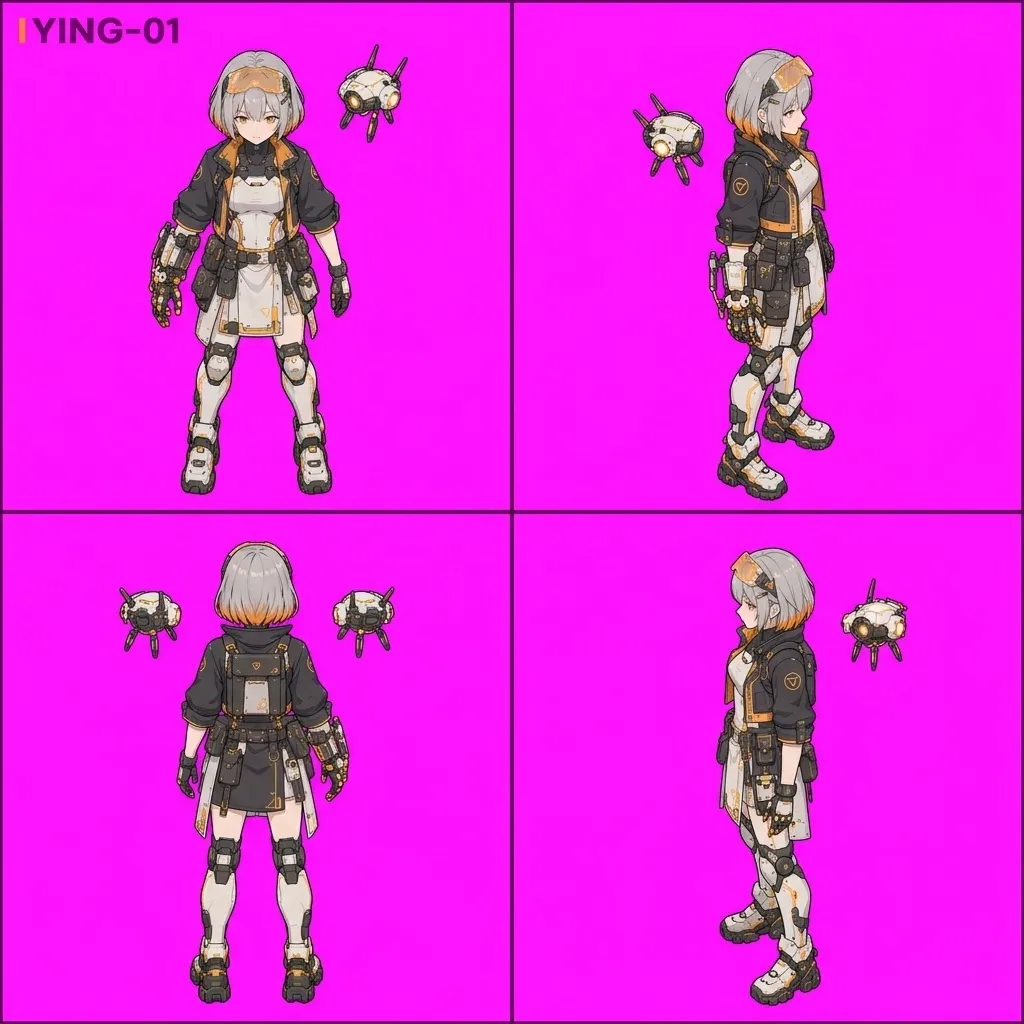
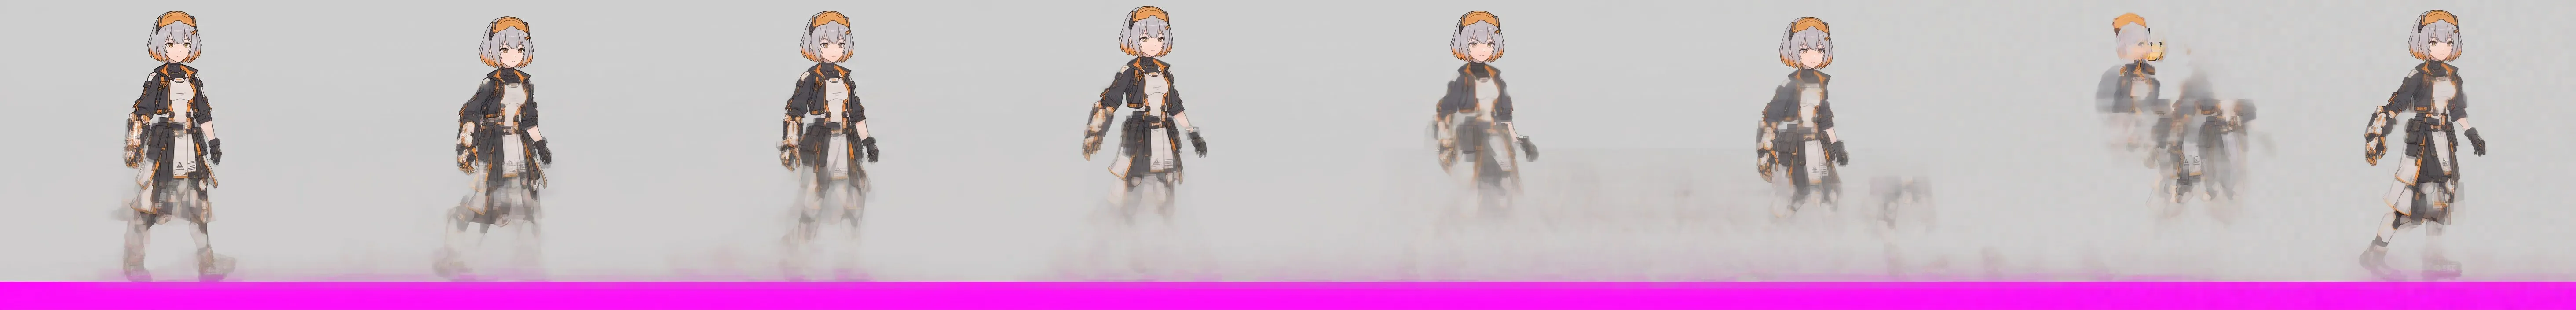
2. Gemini Flash: toda la caminata en una larga tira
Idea simple: hacer que el modelo dibuje una tira 8:1, ocho celdas, ocho fotogramas. Cuanto más bajo bajaba el cuerpo, más borroso se volvía — las piernas básicamente se disolvían — y cada celda tenía un color de fondo diferente, así que no había forma de enmascararlo.
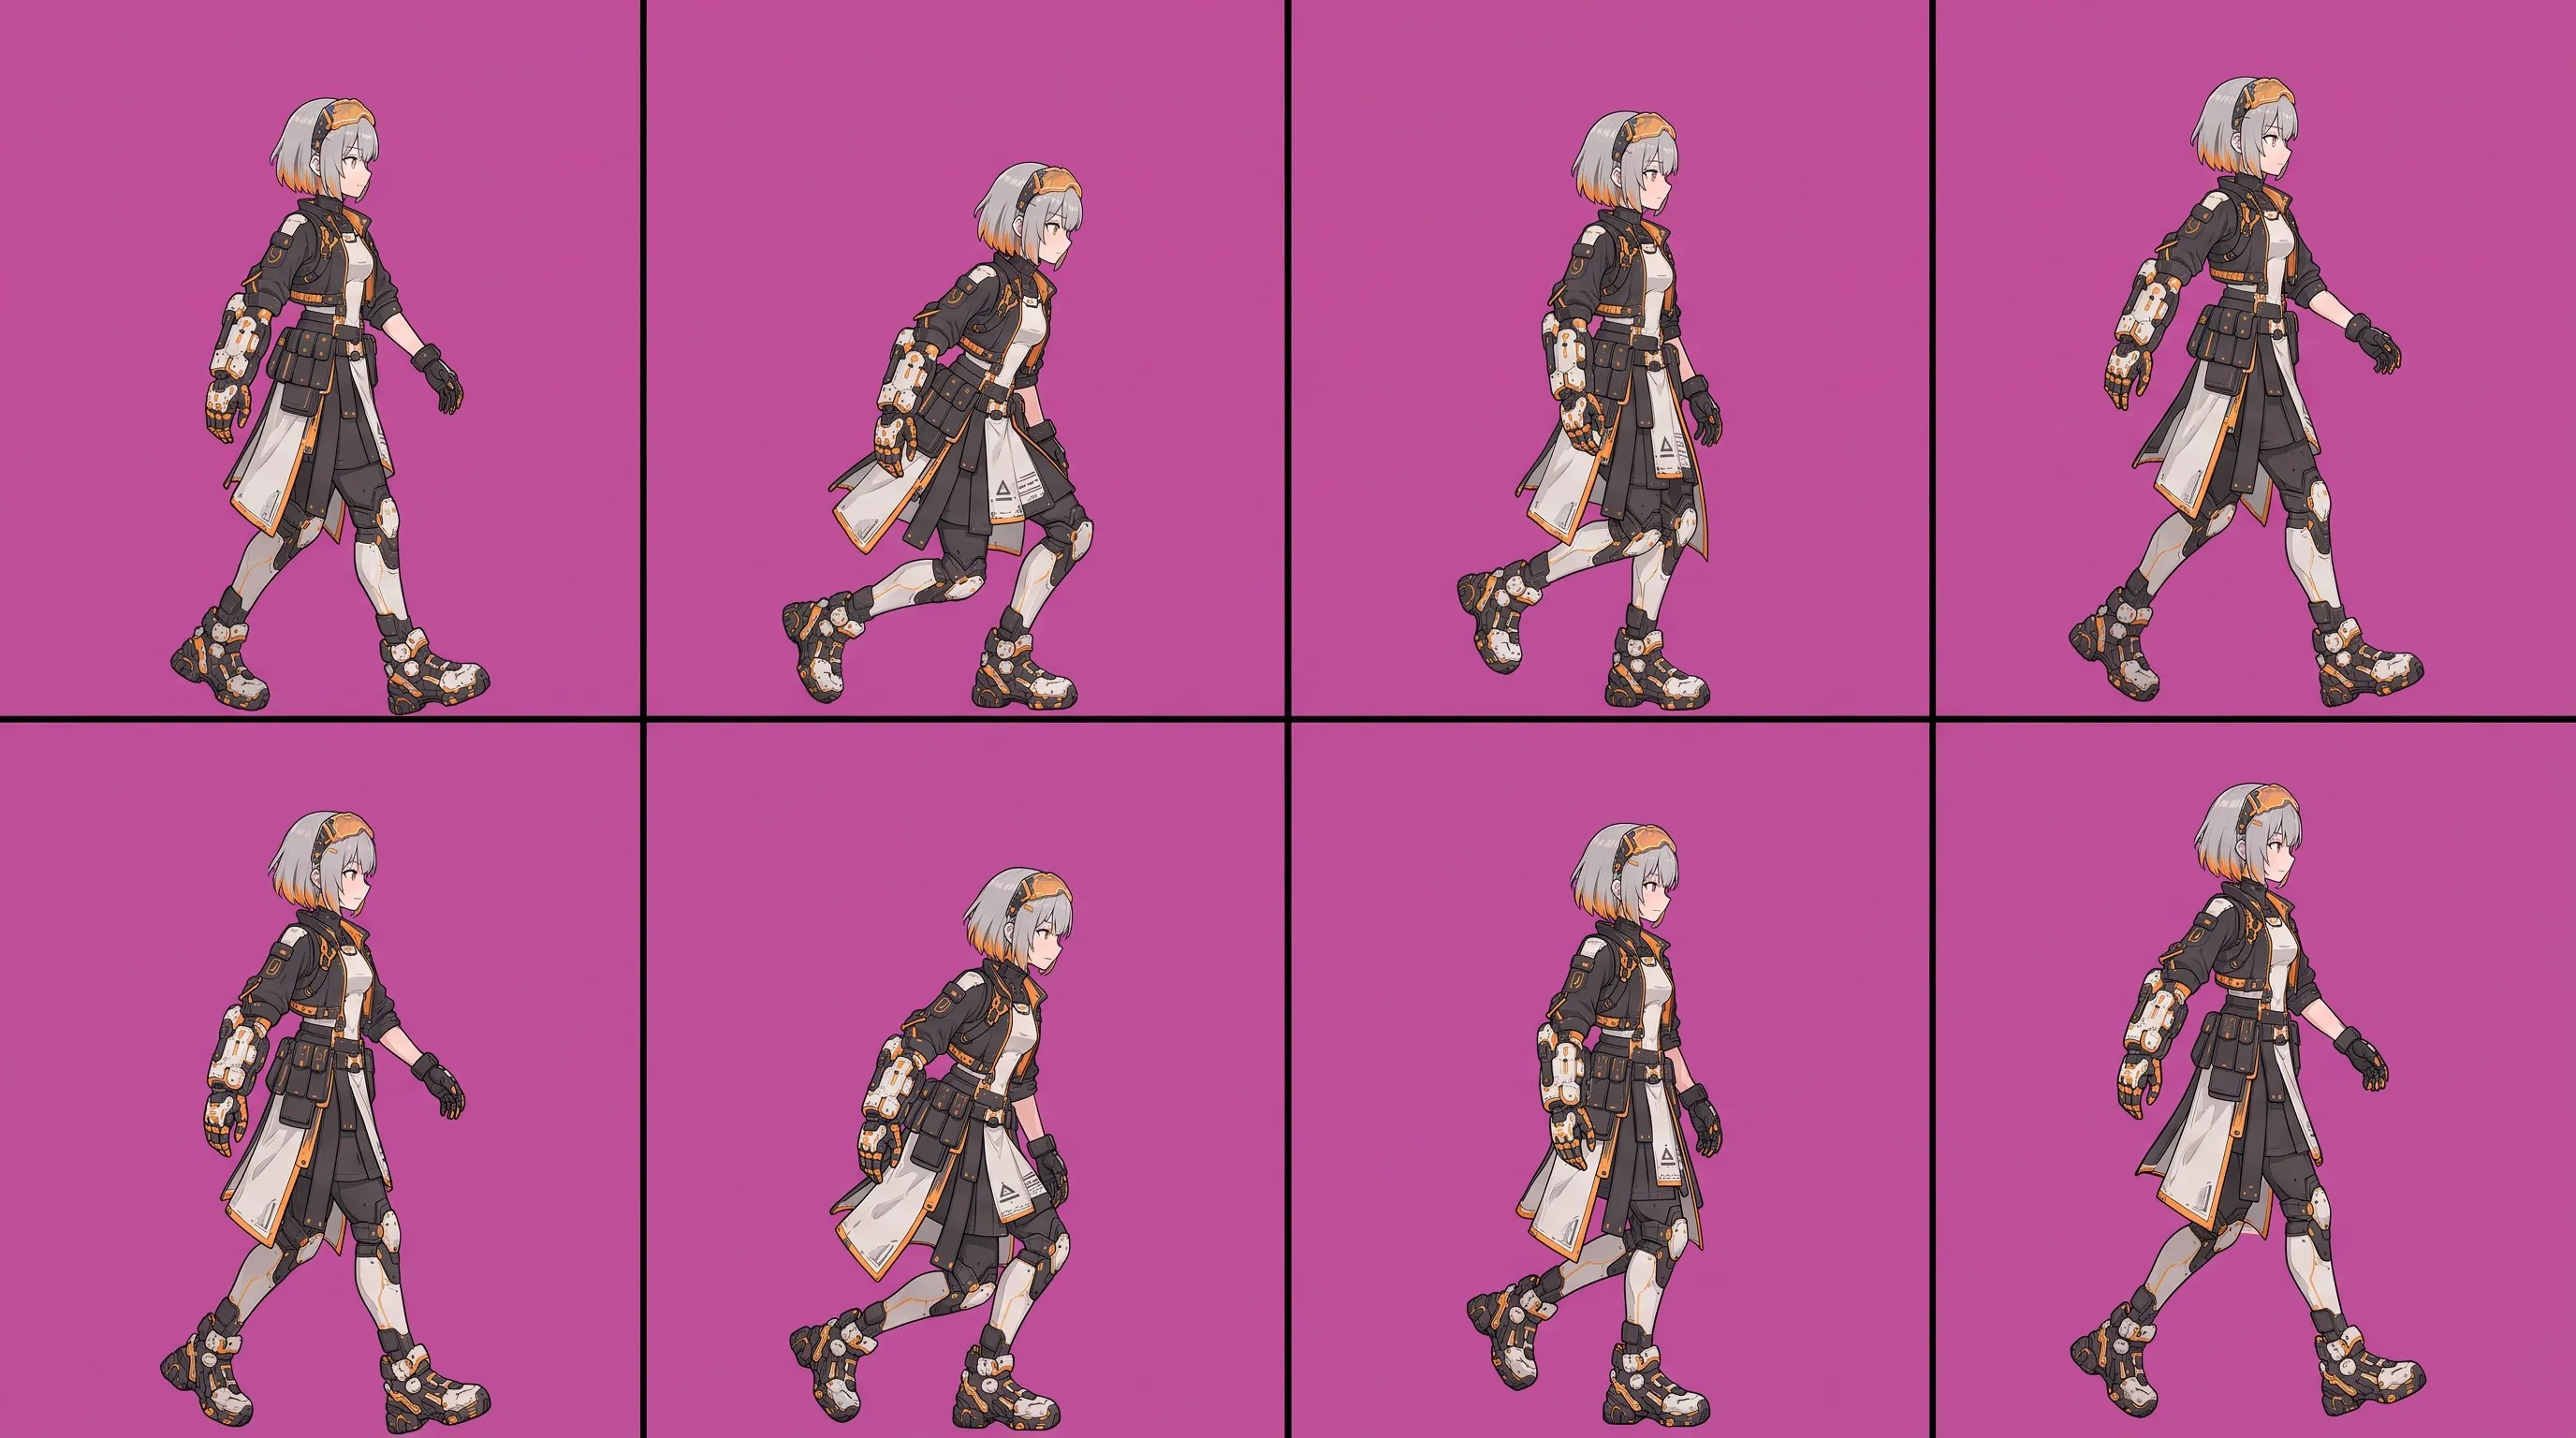
3. Gemini Pro: una cuadrícula
Después, hice que el modelo Pro más fuerte dibujara una cuadrícula de 2×4. Honestamente se veía bien — pero pedí una vista frontal y obtuve una vista lateral, los pasos no fluían de una celda a otra, y el fondo no era un color limpio que pudiera enmascarar.
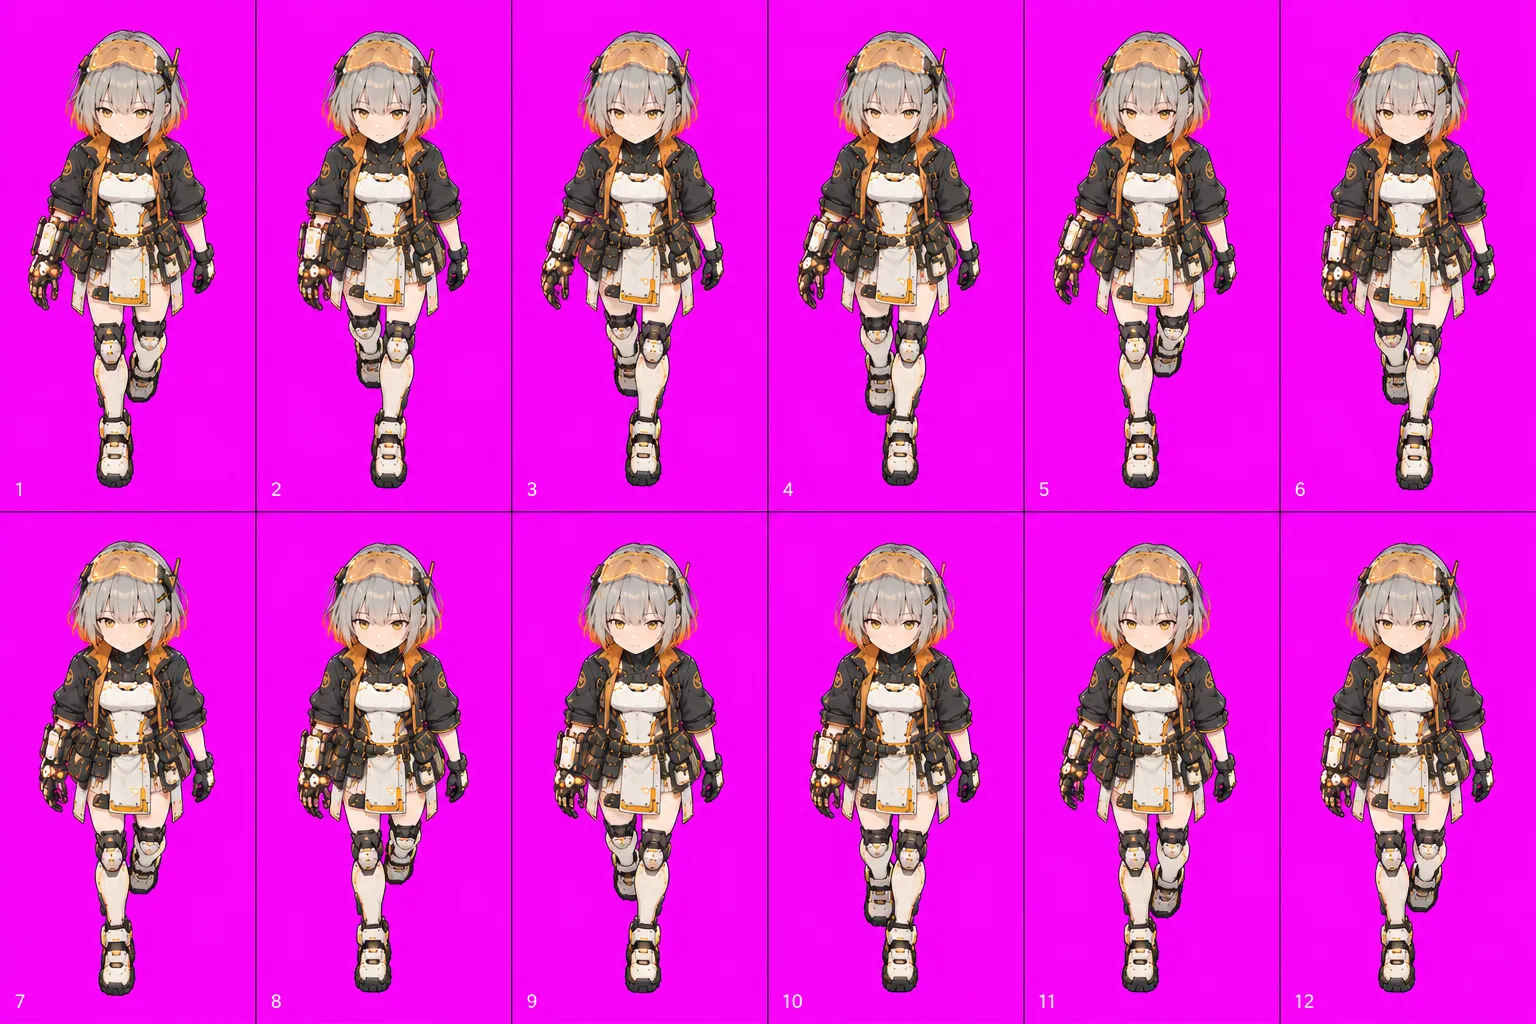
4. ChatGPT: todos los fotogramas en una imagen
ChatGPT es muy confiable en poses individuales, así que le pedí una caminata frontal de 12 celdas en una imagen. El problema es que no tiene sentido de continuidad: las celdas vecinas a menudo intercambian cuál pie está adelante, y no hay poses intermedias donde las piernas se crucen. Al reproducir, simplemente se sacude en el lugar.
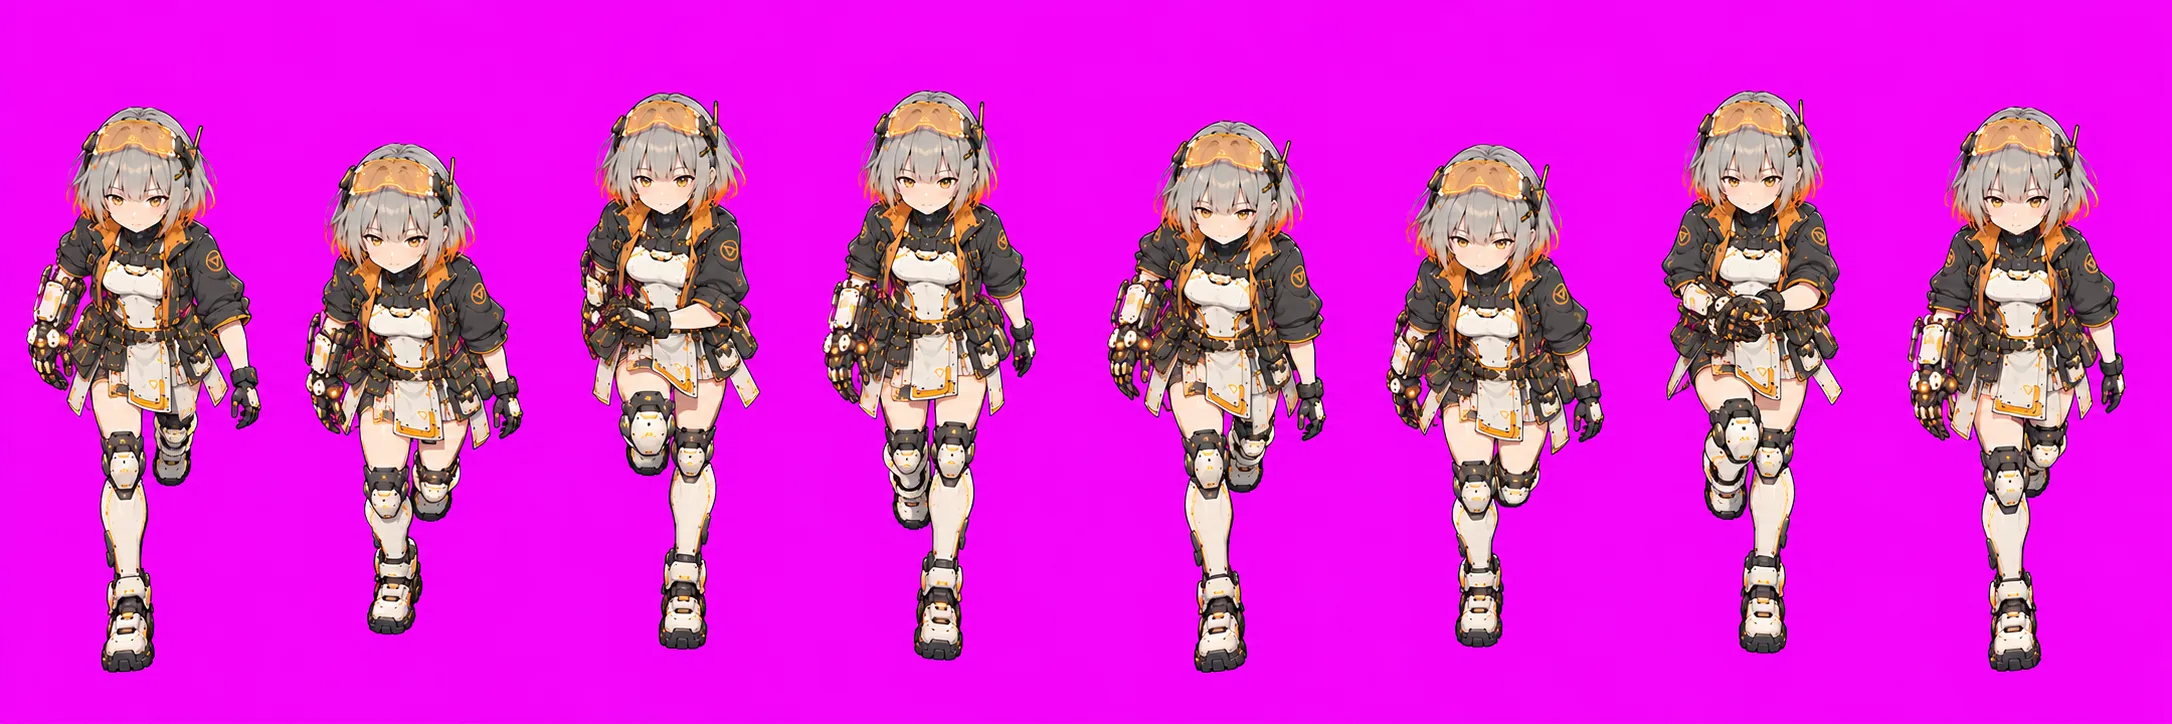
5. Veo: describiendo el movimiento solo con palabras
Si los modelos de imagen no entienden la continuidad, ¿por qué no generar un video de caminata con Veo y extraer fotogramas? El movimiento era continuo ahora — pero con solo una imagen de anclaje más una descripción de texto, caminaba de manera muy “refinada”, sin energía. Y cuanto más largo era el prompt, más se aferraba Veo a una palabra individual y la exageraba.
Lo que finalmente funcionó
En este punto la lección estaba clara: dejar que cada modelo haga solo lo que hace bien.
- ChatGPT (web) solo dibuja poses estáticas: el anclaje de pie, más fotogramas clave en el momento de una zancada grande.
- Veo solo maneja el movimiento entre dos poses: en modo de primer/último fotograma, le das el primer y último fotograma y rellena los 4 segundos intermedios.
- Un script hace el resto: enmascaramiento, normalización de tamaño, selección de fotogramas, empaques de hoja de sprite.
Desglosar el movimiento primero
Antes de generar cualquier cosa, determiné exactamente qué movimientos el juego necesita y cómo se conectan. El movimiento de Ying en el mapa se divide en tres partes:
| Movimiento | Reproducción | Generado desde |
|---|---|---|
| Caminar | Bucle | fotograma clave A → B → A |
| Detenerse | Una vez | fotograma clave → parado |
| Esperar | Bucle | parado → parado (respirar) |
Las reglas de cambio son simples:
presionar una dirección → empezar a caminar inmediatamente (sin transición de inicio; la sensación es prioritaria)soltar la tecla → reproducir "detenerse" una vez, luego pasar a esperarpresionar de nuevo a mitad de parada → interrumpir, volver a caminarOmitir una transición de inicio es intencional: en el momento en que el jugador presiona una tecla, el personaje debe moverse — incluso unos pocos fotogramas de retraso se siente pegajoso. Detenerse es lo opuesto: unos pocos fotogramas de estabilización se ven naturales.
Un truco más: cuando sueltas a mitad de la caminata, la mitad del tiempo el otro pie está adelante. Las vistas frontal y posterior son simétricas de izquierda a derecha, así que en ese caso simplemente reproduzco la animación de parada espejada y se alinea — sin necesidad de video extra. Las vistas laterales no obtienen esto, ya que el espejado también voltearía la dirección de cara.
Desglosado de esta manera, cada dirección necesita solo 2–4 videos cortos, y todo gira alrededor de dos imágenes: el fotograma clave y la pose de pie.
1. Anclaje y fotogramas clave
Primero, ChatGPT dibuja un anclaje de pie de cuatro direcciones con un ángulo superior de 35°. Esto fija el ángulo de la cámara:
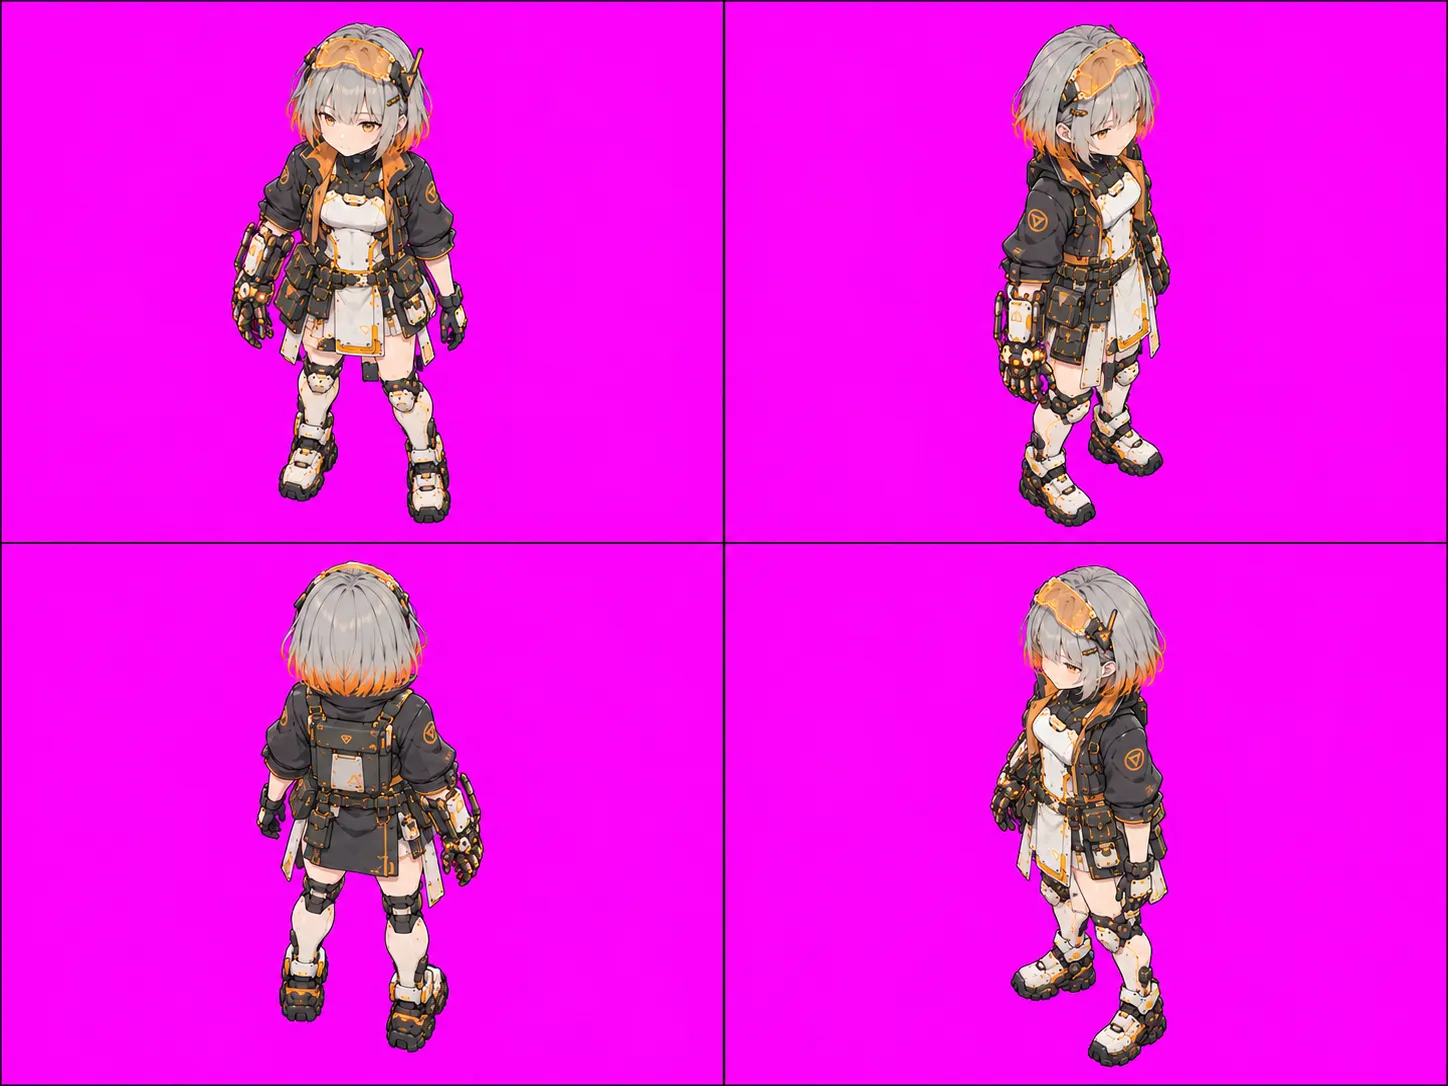
Luego un fotograma clave para cada dirección: el momento de una zancada grande, un pie adelante. Frontal y posterior son simétricos, así que el fotograma “otro pie adelante” es solo un espejo horizontal — no es necesario dibujarlo.
2. Veo rellena el movimiento
Cada dirección obtiene algunos videos de 4 segundos:
- Caminar: fotograma clave A → B espejado, y B → A; une los dos y tienes un ciclo de caminata completo
- Detenerse: fotograma clave → parado
- Esperar: parado → parado, solo respiración suave
Los prompts son lo más cortos posible y solo describen el movimiento, por ejemplo “zancadas largas y vigorosas, mirando a la cámara, cámara estática”. Lección aprendida: cuanto más describes, más se desvía.
3. Vista lateral: la misma imagen para el primer y último fotograma
La vista lateral fue la más difícil. Cuando le pedí a ChatGPT que dibujara la pose lateral con “el otro pie adelante”, las dos imágenes salieron casi idénticas sin importar cómo reescribiera el prompt.
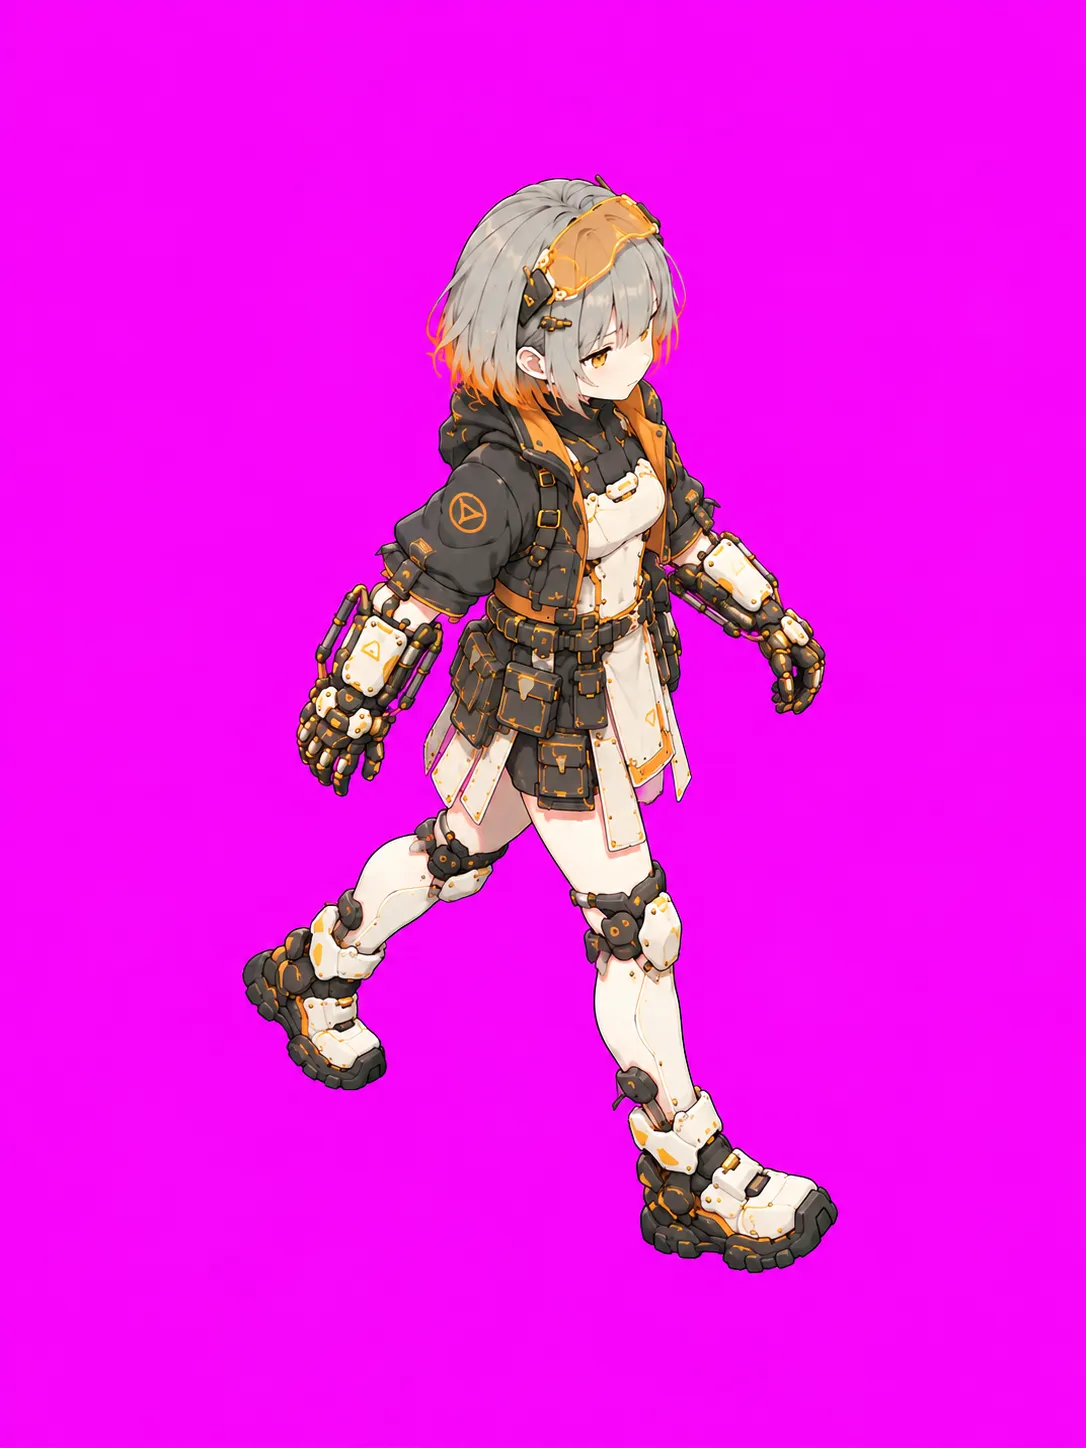
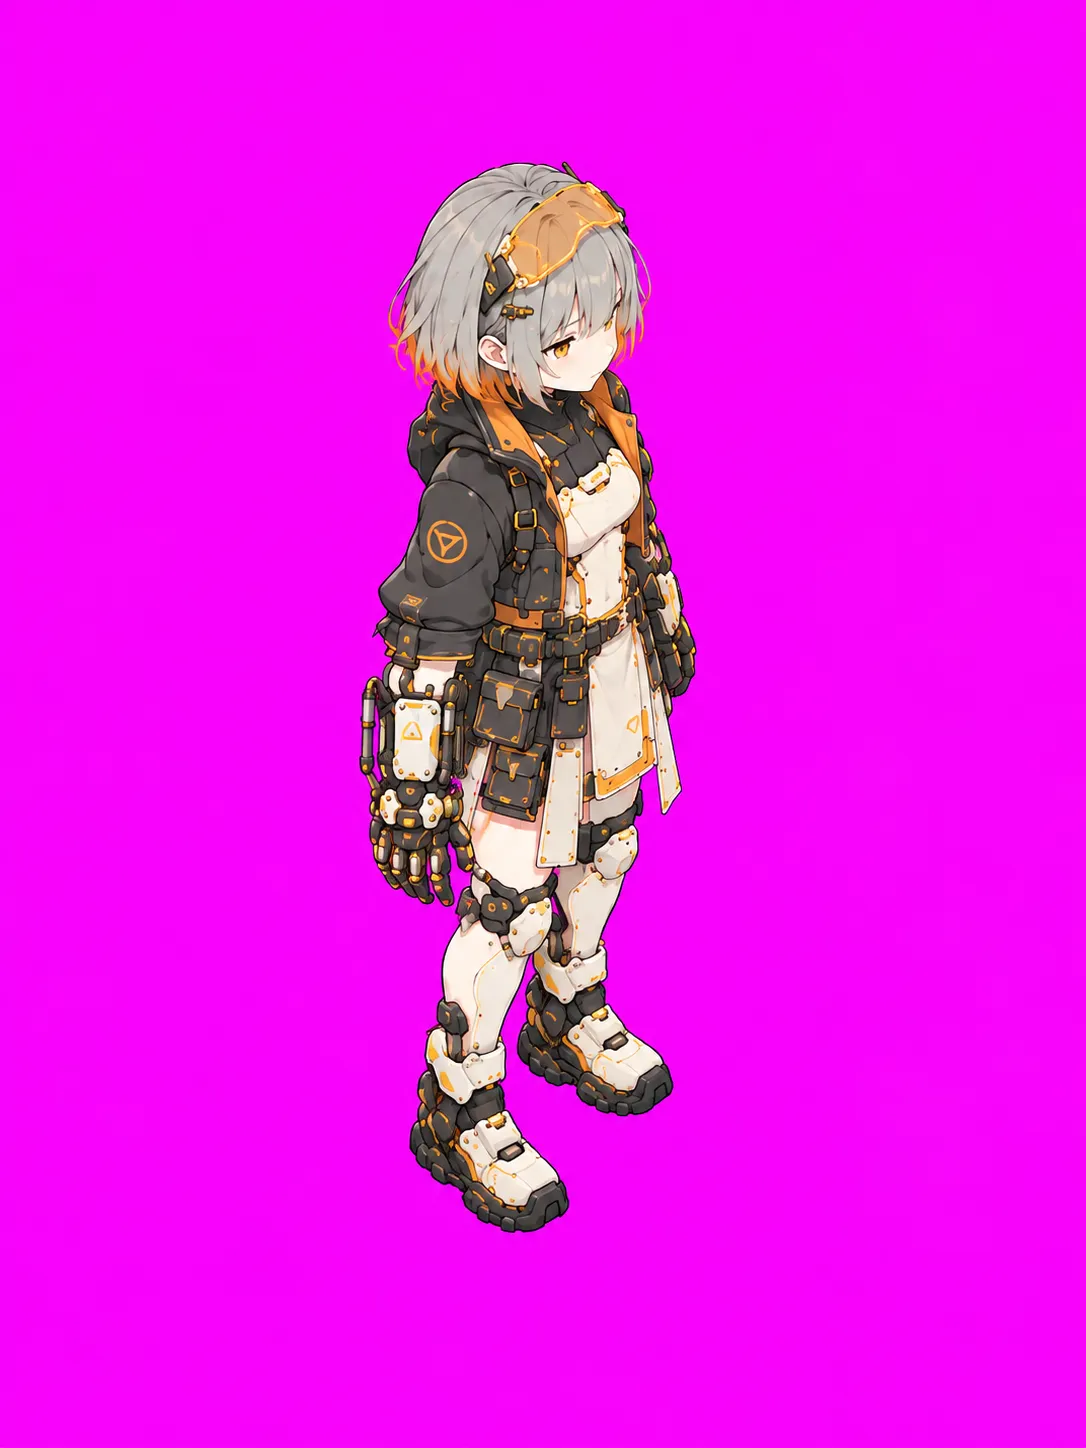
Así que eliminé la segunda imagen por completo: el mismo fotograma clave es tanto el primer como el último fotograma, Veo la camina a través de un ciclo completo de vuelta a la pose inicial, y corté un ciclo de marcha completo del medio del video. De hecho funcionó bien. El oeste es solo el este espejado.
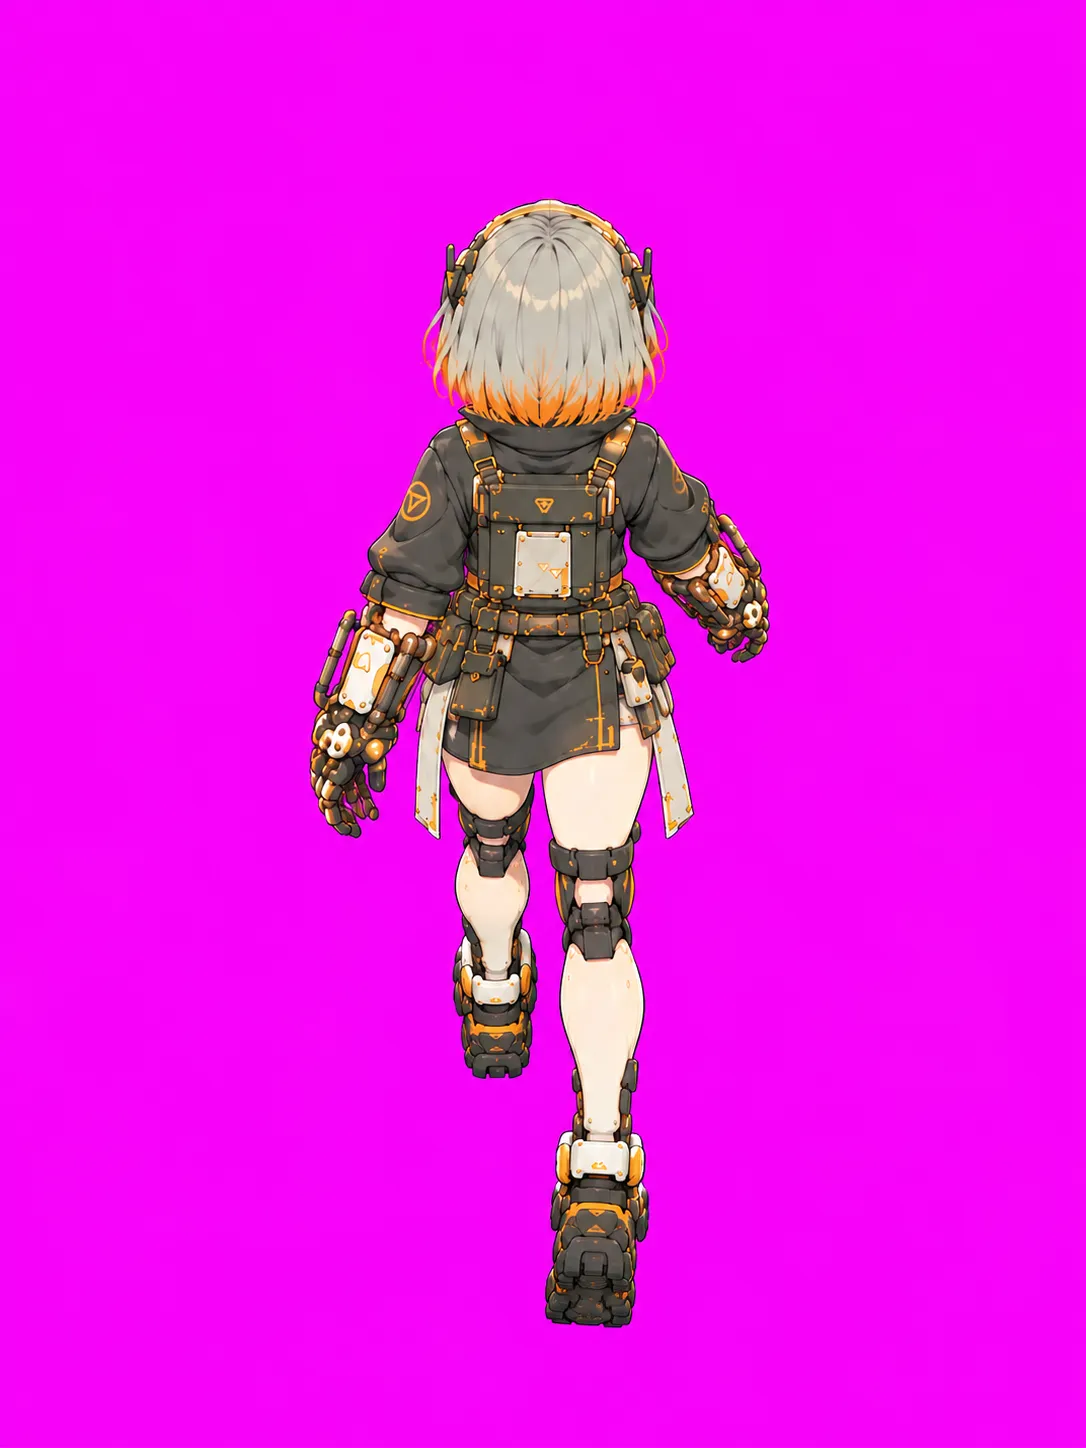
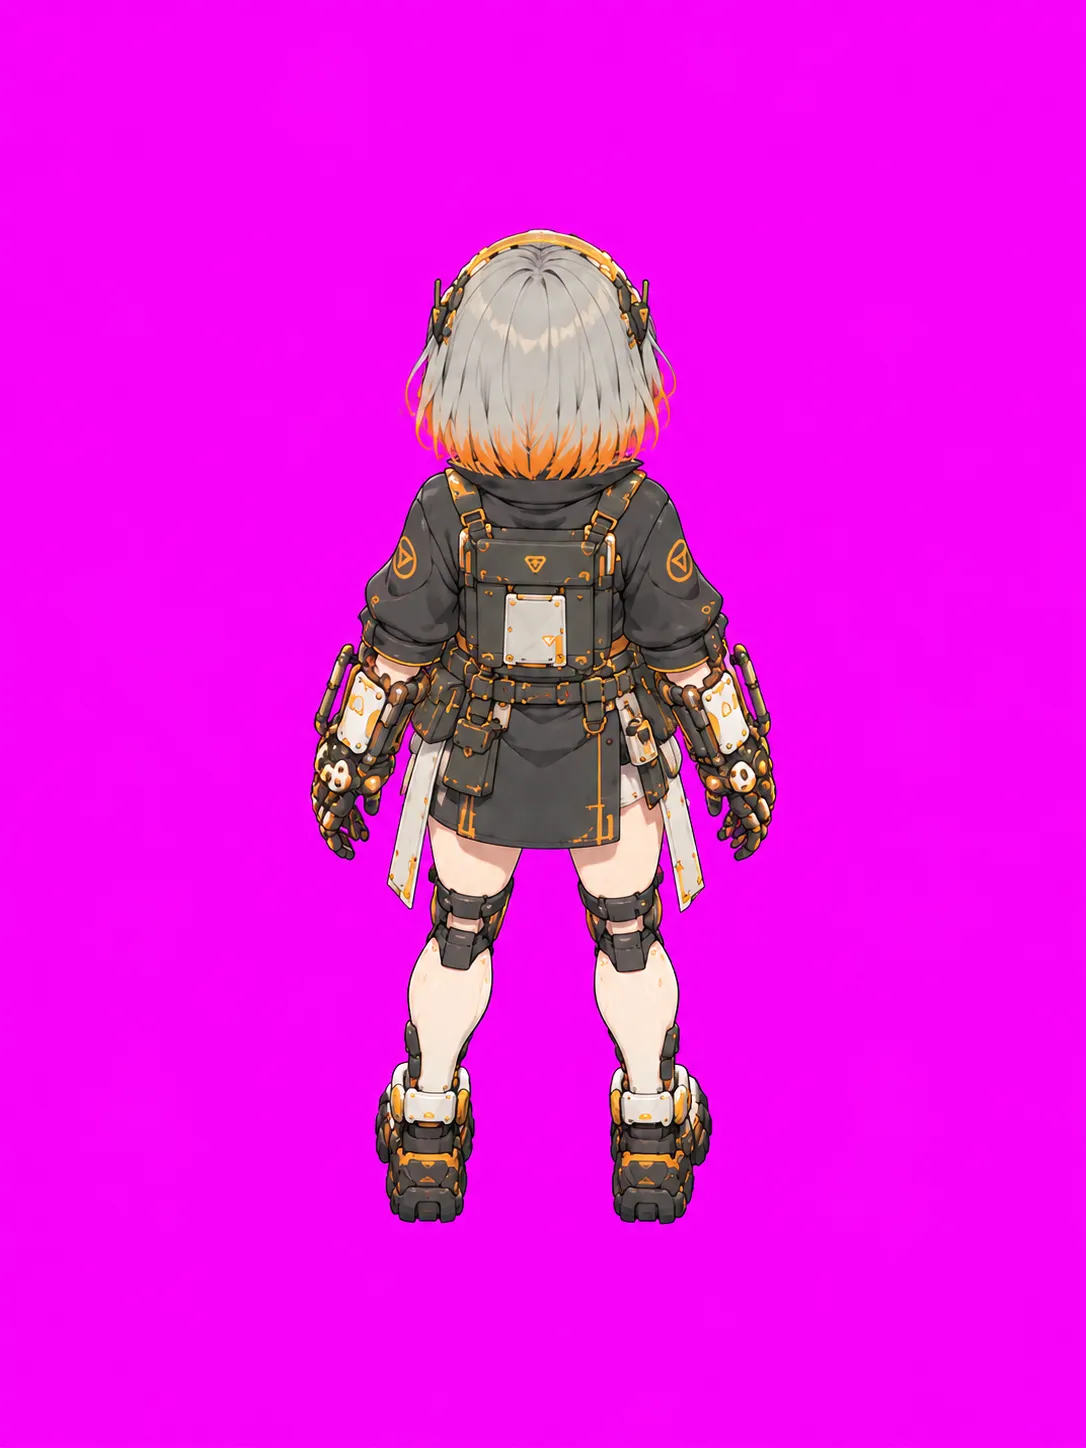
4. Vista posterior: cortando la parte mala
La vista posterior siguió la receta de vista frontal, pero en un video su pierna de repente se disparó hacia la izquierda a mitad de la zancada. Regenerar lo solucionó a la mitad; el resto lo arreglé con una edición — encontré el fotograma más similar en cada lado de la sección mala y los uní directamente. La costura es prácticamente invisible.
5. Selección de fotogramas y corrección de tamaño
La velocidad dentro de un video no es uniforme — algunas partes son rápidas, algunas lentas. Muestrear a intervalos de tiempo fijos y la animación en el juego se entrecorta. Así que muestreo por cantidad de movimiento en su lugar:
cambio entre cada par de fotogramas → suma en una curva de "progreso de movimiento"toma 12 puntos espaciados uniformemente a lo largo de esa curva → esos son los 12 fotogramasOtro problema: los fotogramas clave de ChatGPT se dibujan consistentemente un poco más grandes que la pose de pie, así que crecería y encogería mientras caminaba. La solución es calcular la relación desde el ancho de la cabeza y escalar los fotogramas de caminata de vuelta al tamaño de pie; la animación de parada se ramifica desde el tamaño de caminata al tamaño de pie para que no haya un salto cuando se detenga.
Finalmente, caminar, detenerse y esperar para las cuatro direcciones se empaquetan en una hoja de sprite que el juego lee fila por fila. Aquí está cada movimiento cortado directamente de los videos de Veo originales — sin reducción de escala, sin corrección de color — para que puedas ver el detalle:
Costo
Todo el proceso de prueba y error para Ying, incluido cada intento fallido anterior, costó $6.91 en uso de API (ChatGPT web es una suscripción y no se cuenta).
Conclusiones
- Los modelos de imagen son buenos en poses individuales y malos en fotogramas consecutivos; los modelos de video son lo opuesto. Usa cada uno para su mitad.
- Mantén los prompts cortos y deja que las imágenes de referencia hablen.
- Las vistas laterales no necesitan dos fotogramas clave — usa el mismo como primer y último fotograma.
- Muestrea fotogramas por movimiento, no por tiempo.
Este flujo se reutilizará para Ju y Yao, y para nuevas acciones como trabajar. Esperemos que la próxima vez con menos tropiezos (๑•̀ㅂ•́)و✧